Quellcode-Lektüre: Harbor-Operator
Vorbereitungen
Warum Harbor-Operator?
Worse is Better?
Was ist gute Software?
In einem berühmten Artikel aus den späten 80er Jahren, “The Rise of Worse is Better”, erwähnt der Autor, dass ein gutes Softwaredesign die vier Eigenschaften Einfachheit, Korrektheit, Konsistenz und Vollständigkeit berücksichtigen sollte.
Der Autor erwähnt zwei Designphilosophien, die wir vorläufig “the right thing” und “worse is better” nennen (es ist wichtig anzumerken, dass letztere Bezeichnung nicht abwertend gemeint ist). Beide Philosophien drehen sich um die genannten Eigenschaften, unterscheiden sich jedoch in der Priorisierung dieser Eigenschaften.
The right thing
- Einfachheit - Das Design muss einfach und verständlich sein. Einfache Schnittstellen sind wichtiger als einfache Implementierungen.
- Korrektheit - Das Design muss korrekt sein. Hier darf es keine Kompromisse geben.
- Konsistenz - Konsistenz ist genauso wichtig wie Korrektheit. Daher können Einfachheit und Vollständigkeit etwas zurückstehen.
- Vollständigkeit - Das Design muss eine Vielzahl möglicher Szenarien berücksichtigen. Vollständigkeit darf nicht übermäßig zugunsten der Einfachheit geopfert werden.
Worse is better
- Einfachheit - Das Design muss einfach und verständlich sein. Einfache Implementierungen sind wichtiger als einfache Schnittstellen. Einfachheit ist die wichtigste Eigenschaft.
- Korrektheit - Das Design muss korrekt sein, aber Einfachheit ist etwas wichtiger als Korrektheit.
- Konsistenz - Das Design sollte nicht zu inkonsistent sein. Konsistenz kann zugunsten der Einfachheit geopfert werden. Wenn Einfachheit gewährleistet ist, kann Konsistenz auch für Vollständigkeit geopfert werden.
- Vollständigkeit - Das Design muss eine Vielzahl möglicher Szenarien berücksichtigen. Vollständigkeit kann jederzeit geopfert werden, um die Einfachheit des Designs zu gewährleisten.
Der Autor führt dann viele Beispiele für beide Ansätze an, um zu argumentieren, warum “worse-is-better” damals die Softwarebranche eroberte.
Diese beiden Philosophien sind nicht als besser oder schlechter zu bewerten. Heute finden wir beide in unserer Umgebung, und die Realität bewegt sich oft zwischen ihnen. Wir möchten ein exzellentes, ästhetisch wertvolles Design schaffen, müssen aber auch Kosten und menschliche Faktoren berücksichtigen. Letztendlich müssen wir qualitativ angemessene, funktionierende Software liefern, um reale Probleme zu lösen, wobei die Kosten für Entwicklung und Wartung der Software auf keinen Fall den Wert des Problems selbst übersteigen dürfen.
Golang - die Sprache
Golang ist fast ein Paradebeispiel für die “worse is better”-Philosophie:
- Es bündelt die jahrelange praktische Erfahrung von Google mit C++.
- Es ist so einfach, ohne komplexe Funktionen, dass es für die Lösung eines Problems im Grunde nur einen “Building Block” gibt. Das bedeutet:
- Man kann es fast ohne Aufwand für die Sprache selbst leicht beherrschen.
- Der Code ist sehr gut lesbar.
- Schnelle Kompilierung, sogar auf Kosten von Generics (die ursprünglich fehlten).
- Parallele Aufgaben können sehr einfach über Goroutinen ausgeführt werden.
- Das Sprachmerkmal der Ausnahmebehandlung (Exception Stack) wurde fast vollständig aufgegeben und eine explizite Fehlerprüfung und -behandlung erzwungen.
- Einmal kompiliert, überall ausführbar.
Kubernetes - die Plattform
Kubernetes ist allen bekannt, daher werde ich nicht den Besserwisser spielen. Kurz gesagt: Es bietet ein konzeptionell sehr einfaches API-Design, ergänzt durch einen Regelungsmechanismus aus der Kybernetik, der die automatisierte Bereitstellung, Skalierung und den Betrieb containerisierter Software ermöglicht.
K8s erlaubt es Entwicklern, seine Fähigkeiten durch Offenlegung dieser API-Spezifikation und des Regelungsmechanismus zu erweitern. Entwickler können das Operator-Pattern implementieren: Das Wissen über Softwarekonfiguration, Bereitstellung (Day-1) sowie Betrieb, Backup, Failover (Day-2) wird in Software geschrieben, die die Software bedient, um diese komplexen und fehleranfälligen Operationen zu automatisieren. Dies erhöht die Zuverlässigkeit und senkt die Kosten.
Der Grund für die Wahl des Harbor-Operators ist also sein ausgezeichnetes Design. Auf einer hervorragenden Plattform und mit einfachen Sprachmerkmalen, ohne übermäßige Trickserei, realisiert er durch einige Schlüsseldesigns, die den SOLID-Designprinzipien entsprechen, ein pragmatisches und ästhetisch wertvolles Softwaresystem, das als Praktizierender der “the right thing”-Philosophie angesehen werden kann.
Der Code des Autors hat fast keine Kommentare, ist aber außergewöhnlich gut lesbar, was auch dem gesamten System zu verdanken ist.
Ziele
Die Abstraktion und Vereinfachung von Problemen geht zwangsläufig mit einem Verlust an Flexibilität einher. Der Harbor-Operator opfert Flexibilität vollständig, um maximale kognitive Entlastung zu bieten, sodass die Entwicklung eines Operators eher der Deklaration einer Softwarekonfiguration gleicht.
Das manuelle Schreiben eines Operators mit client-go ist dank des Fehlens von Generics in Golang eine Qual. Das Projekt wäre mit einer riesigen Menge an Boilerplate-Code (Vorlagencode) übersät. Ich glaube, selbst wenn jemand wirklich mit client-go von Hand schreiben würde, würde niemand wirklich bei Null anfangen.
Daher entstand kubebuilder. Es abstrahiert die Erstellung des Kubernetes-Clients, das Abhören von Anfragen an den Kubernetes-API-Server und deren Einreihung in Warteschlangen in eine gemeinsame Bibliothek (controller runtime) und gemeinsame Tools (controller tools). Es kann für Entwickler Gerüstcode generieren, der sich auf die Geschäftslogik zur Verarbeitung von Änderungsanfragen für API-Objekte konzentriert.
Kubebuilder bewahrt immer noch einen Hauch von Vielfalt in der Geschäftslogik. Der Harbor-Operator strebt darauf aufbauend weiter nach Perfektion, opfert Flexibilität vollständig, um konzeptionelle Konsistenz und Einfachheit zu erreichen – und die Geschäftsanforderungen, denen er gegenübersteht, eignen sich tatsächlich sehr gut für diesen Ansatz.
Daher ist unser Hauptziel in dieser Quellcode-Lektüre, vom Harbor-Operator zu lernen:
- Wie Day-1-Operationen durchgeführt werden.
- Wie die Redundanz von Operator-Code weiter reduziert wird, indem derselbe Controller-Code für elf Controller auf unterschiedlichen CRD-Ebenen verwendet wird.
- Wie DAG genutzt wird, um Abhängigkeiten zwischen Ressourcen zu lösen (der Autor scheint dafür sogar ein Patent angemeldet zu haben).
Darüber hinaus werden wir uns nicht schwerpunktmäßig mit Folgendem befassen:
- Day-2-Operationen im Harbor-Operator (diese Funktionen sind in der aktuellen Version noch nicht stabil).
- Dem Quellcode und den Funktionen von Harbor selbst.
Quellcode-Lektüre
Statische Struktur
Verzeichnisstruktur
Hier sind nur die Verzeichnisse aufgelistet.
    root
    ├── apis
    │   ├── goharbor.io
    │   │   └── v1alpha3
    │   └── meta
    │       └── v1alpha1
    ├── controllers
    │   ├── controller_string.go
    │   ├── controllers.go
    │   └── goharbor
    │       ├── chartmuseum
    │       ├── controller_test.go
    │       ├── core
    │       ├── exporter
    │       ├── harbor
    │       ├── harborcluster
    │       ├── internal
    │       ├── jobservice
    │       ├── notaryserver
    │       ├── notarysigner
    │       ├── portal
    │       ├── registry
    │       ├── registryctl
    │       └── trivy
    ├── pkg
    │   ├── builder
    │   ├── cluster
    │   │   ├── controllers
    │   │   │   ├── cache
    │   │   │   ├── common
    │   │   │   ├── database
    │   │   │   │   └── api
    │   │   │   ├── harbor
    │   │   │   └── storage
    │   │   ├── gos
    │   │   ├── k8s
    │   │   └── lcm
    │   ├── config
    │   │   ├── harbor
    │   │   └── template
    │   ├── controller
    │   │   ├── errors
    │   │   ├── internal
    │   │   │   └── graph
    │   │   └── mutation
    │   ├── event-filter
    │   ├── exit
    │   ├── factories
    │   │   ├── application
    │   │   ├── logger
    │   │   └── owner
    │   ├── graph
    │   ├── harbor
    │   ├── image
    │   ├── manager
    │   ├── resources
    │   │   ├── checksum
    │   │   └── statuscheck
    │   ├── scheme
    │   ├── setup
    │   ├── status
    │   ├── template
    │   ├── tracing
    │   ├── utils
    │   │   └── strings
    │   └── version
    ...
Schlüssel-Interfaces

Systemarchitektur
Bis Version v1.0.1 ist der Harbor-Operator hauptsächlich für die Day-1-Operationen des Harbor-Systems verantwortlich. 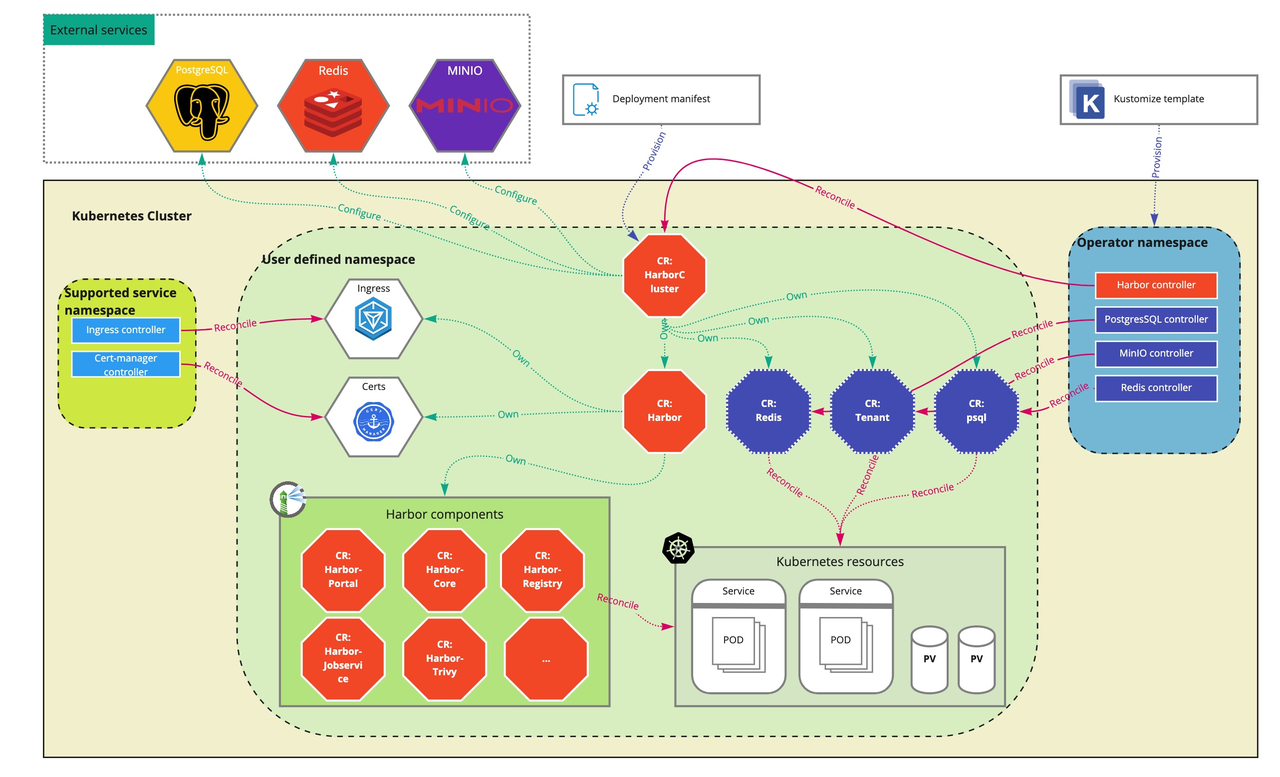
Das Wesentliche im Blick: HarborCluster
Lassen Sie uns zunächst einige weniger kritische Teile ausblenden: Die CRD HarborCluster und die Implementierung ihres Controllers.
Warum ist sie besonders? Betrachten Sie zunächst ihre Position in der Systemarchitektur: Sie befindet sich auf der obersten Ebene und verwaltet das Harbor-System selbst sowie alle davon abhängigen Stateful Services. Dies muss aus der Projektgeschichte und ihrer besonderen Stellung in der Systemarchitektur erklärt werden.
Aus systemarchitektonischer Sicht ähnelt die Definition dieser HarborCluster-CRD der Harbor-CRD stark, der Code weist große Redundanzen auf und sieht nicht sehr schön aus. Das liegt daran, dass sie als die oberste (äußerste) CRD im System direkt dem Benutzer gegenübersteht. Sie muss dem Benutzer alle notwendigen Konfigurationsoptionen für die Bereitstellung von Harbor bereitstellen. Da Harbor selbst ein zustandsloser Dienst ist, erfordert eine vollständige Bereitstellung außerdem, dass die HarborCluster-CRD alle Stateful Services verwaltet, von denen das Harbor-System abhängt, einschließlich Postgres, Minio und Redis.
Die notwendigen Informationen für das Harbor-System selbst sind bereits in der Harbor-CRD definiert. Daher besteht der redundante Teil in der HarborCluster-CRD darin, diese Informationen vollständig und korrekt an die Harbor-CRD weiterzugeben. Darüber hinaus muss die HarborCluster-CRD die CRDs der Stateful Services verwalten, die außerhalb ihrer eigenen Zuständigkeitsgrenzen liegen, und kann daher nicht vollständig die Controller-Logik aus Harbor und allen seinen Unterkomponenten verwenden.
Aus historischer Sicht war der Harbor-Operator ursprünglich ein privates Projekt von OVH Cloud und wurde später der goharbor-Community gespendet. Betrachtet man also die Git-Historie, liegt der Grund für die große Inkonsistenz zwischen der CRD-Definition von HarborCluster und ihrer Controller-Implementierung im Vergleich zu anderen Controllern im System darin, dass sie ein späterer Community-Beitrag ist und ihre Funktionen bei der ursprünglichen Design des Harbor-Operators nicht berücksichtigt wurden.
Die Implementierung des HarborCluster-Controllers selbst unterscheidet sich nicht wesentlich von den meisten Controllern, die mit Controller-Runtime implementiert sind, und wird daher nicht detailliert untersucht.
HarborCluster Controller

Harbor Core Controller

Abhängigkeiten zwischen Ressourcen lösen: Dependency Graph
Der Abhängigkeitsgraph ist ein relativ unabhängiges Modul im gesamten Projekt, aber es fungiert tatsächlich als Ausführungsmotor für alle Controller im Harbor-Operator. Im Wesentlichen wird beobachtet, dass zwischen verschiedenen Ressourcentypen in Kubernetes gegenseitige Abhängigkeiten bestehen. Die Bereitstellung und Regelung einiger Ressourcen hängt von der Bereitstellung und Regelung anderer Ressourcen ab, z. B. kann ein Deployment von einem ConfigMap abhängen. Letztendlich bilden diese Abhängigkeiten einen Abhängigkeitsgraphen, der eigentlich ein DAG sein sollte. Hier benötigen wir die folgende Schnittstellendefinition:
    package graph

    type Resource interface{}

    type RunFunc func(context.Context, Resource) error

    type Manager interface {
            Run(ctx context.Context) error
            AddResource(ctx context.Context, resource Resource, blockers []Resource, run RunFunc) error
    }

    type resourceManager struct {
       resources map[Resource][]Resource
       functions map[Resource]RunFunc

       lock sync.Mutex
    }
Resourcedefiniert eine abstrakte Ressource. Da sich dieses Modul nicht dafür interessiert, was eine Ressource genau darstellt, und um bei den Einschränkungen der Ausdruckskraft der Sprache maximale Flexibilität zu bewahren, wird der Top-Typinterface{}verwendet.RunFuncist dafür verantwortlich, die konkrete Operation für eine Ressource durchzuführen. Hier stehtRunFuncvor einem Typsicherheitsproblem:interface{}bedeutet, dass der Compiler nichts über diesen Typ weiß und daher nicht eingreifen kann. AberRunFuncmuss mit diesem Typ, der alles sein kann, etwas anfangen. Daher gehen wir davon aus, dass es eine Typumwandlung (Type Assertion) durchführen muss. Wenn jedeRunFuncfür jede Ressource manuell in einen konkreten Typ umgewandelt werden müsste, wäre das sehr langweilig und ekelhaft. Später werden wir sehen, wie der Harbor-Operator die Drecksarbeit an einer Stelle konzentriert.Managerhat nur zwei Methoden: Ressource hinzufügen und den Graphen ausführen. Beide müssen untersucht werden.- Die Datenstruktur
resourceManager, dieManagerimplementiert, ist ebenfalls einfach definiert:- Eine Map
resource -> blockers - Eine Map
resource -> runFunc - Ein
lockzur Behandlung der Nebenläufigkeit bei Map-Operationen. Daraus können wir ersehen, dass der Autor Datenstrukturen wieSync.Map, die nebenläufigkeitssicher, aber nicht typsicher sind, nicht mag. Das macht uns noch neugieriger darauf, wie der Autor mit so vielen (11 Komponenten)RunFuncs umgeht.
- Eine Map
Da es sich um einen Graphen handelt, muss es eine Datenstruktur für den Graphen und eine Factory-Methode zum Erstellen dieses Graphen geben. Die Datenstruktur von resourceManager wirkt etwas steif, es ist unklar, ob dies der eigentliche Graph ist.
AddResource
Gemäß der Signatur kann man sehen, dass AddResource die hinzuzufügende Ressource selbst, alle ihre Abhängigkeiten und die entsprechende runFunc hinzufügt. Es ist bemerkenswert, dass zuerst Ressourcen hinzugefügt werden müssen, die von keiner anderen Ressource abhängen (d. h. mit Ausgangsgrad 0).
    func (rm *resourceManager) AddResource(ctx context.Context, resource Resource, blockers []Resource, run RunFunc) error {
       if resource == nil {
          return nil
       }

       if run == nil {
          return errors.Errorf("unsupported RunFunc value %v", run)
       }

       span, _ := opentracing.StartSpanFromContext(ctx, "addResource", opentracing.Tags{
          "Resource": resource,
       })
       defer span.Finish()

       nonNilBlockers := []Resource{}

       for _, blocker := range blockers {
          if blocker == nil {
             continue
          }

          nonNilBlockers = append(nonNilBlockers, blocker)

          _, ok := rm.resources[blocker]
          if !ok {
             return errors.Errorf("unknown blocker %+v", blocker)
          }
       }

       rm.lock.Lock()
       defer rm.lock.Unlock()

       _, ok := rm.resources[resource]
       if ok {
          return errors.Errorf("resource %+v already added", resource)
       }

       rm.resources[resource] = nonNilBlockers
       rm.functions[resource] = run

       return nil
    }
Run
Fast die gesamte wichtige Logik in diesem Paket befindet sich in der Methode Run. Sehen wir uns zuerst die erste Hälfte an:
    func (rm *resourceManager) Run(ctx context.Context) error {
       span, ctx := opentracing.StartSpanFromContext(ctx, "walkGraph", opentracing.Tags{
          "Nodes.count": len(rm.resources),
       })
       defer span.Finish()

       g := errgroup.Group{}
       l := logger.Get(ctx)

       for _, no := range rm.getGraph(ctx) {
       ...
Da ist es! getGraph. Es sieht so aus, als ob der Graph erstellt werden soll. Gehen wir hinein und stellen fest, dass resourceManager tatsächlich nur ein Builder ist. Der eigentliche Graph ist hier versteckt, ausgedrückt als Adjazenzliste. Auf den ersten Blick sieht es sogar komplex aus:
    type node struct {
       resource Resource
       fn       RunFunc

       parent      chan error
       parentLock  *sync.Mutex
       parentCount int

       children     []chan<- error
       childrenLock []*sync.Mutex
    }

    func (no *node) Wait(ctx context.Context) error {...}
    func (no *node) Terminates(err error) (result error) {...}
    func (no *node) AddChild(child *node) {...}
Warum sind parent und children ein Channel? Warum so viele Locks? Schauen wir uns den Erstellungsprozess des Graphen an:
    func (rm *resourceManager) getGraph(ctx context.Context) []*node {
       span, _ := opentracing.StartSpanFromContext(ctx, "getGraph")
       defer span.Finish()

       rm.lock.Lock()
       defer rm.lock.Unlock()

       graph := make(map[Resource]*node, len(rm.resources))
       result := make([]*node, len(rm.resources))

       i := 0

       for resource, blockers := range rm.resources {
          blockerCount := len(blockers)

          node := &node{
             resource: resource,
             fn:       rm.functions[resource],

             parent:      make(chan error, blockerCount),
             parentLock:  &sync.Mutex{},
             parentCount: blockerCount,

             children:     []chan<- error{},
             childrenLock: []*sync.Mutex{},
          }
          graph[resource] = node
          result[i] = node

          i++

          blockers := blockers

          defer func() {
             for _, blocker := range blockers {
                graph[blocker].AddChild(node)
             }
          }()
       }

       return result
    }
Die Abhängigkeitsbeziehung wurde also umgedreht. Jetzt zeigen die abhängigen Ressourcen auf die Ressource, die von ihnen abhängt. Für jede Ressource wird ein node konstruiert. Gleichzeitig wird für jede Abhängigkeit dieser Ressource der parent-Channel dieser Ressource zu den children der abhängigen Ressource hinzugefügt. Der endgültige Graph ist eine Sammlung von nodes.
Das ist zunächst verwirrend. Schauen wir uns also den Ausführungsprozess an:
    for _, no := range rm.getGraph(ctx) {
       no := no

       g.Go(func() (err error) {

          defer func() {
             err := no.Terminates(err)
             if err != nil {
                l.Error(err, "failed to terminate node when running graph")
             }
          }()

          err = no.Wait(ctx)
          if err != nil {
             return err
          }

          err = no.fn(ctx, no.resource)

          return err
       })
    }
Sehr einfacher Ansatz: Für jeden node wird gewartet, bis seine eingehenden nodes (Eltern) ausgeführt sind, dann wird seine eigene runFunc ausgeführt, und potenzielle Fehler werden an alle nachfolgenden nodes in der Kette weitergegeben, um sie vorzeitig abzubrechen.
Ich verstehe hier nicht ganz, warum nicht eine topologische Sortierung verwendet wird, um dieses gut definierte klassische Problem zu lösen.
Initialisierung
    Die Initialisierung des `GraphManager` verwendet eine thread-lokale globale Variable, die nach der Initialisierung in den Äther (ctx) geworfen wird – eine gängige Dependency-Injection-Methode in verschiedenen API-Frameworks.
    func (c *Controller) NewContext(req ctrl.Request) context.Context {
            ctx := context.TODO()
            application.SetName(&ctx, c.GetName())
            application.SetVersion(&ctx, c.GetVersion())
            application.SetGitCommit(&ctx, c.GetGitCommit())
            ctx = sgraph.WithGraph(ctx)

            logger.Set(&ctx, c.Log.WithValues("request", req))

            return ctx
    }

    func WithGraph(ctx context.Context) context.Context {
            return context.WithValue(ctx, &graphKey, graph.NewResourceManager())
    }

    func Get(ctx context.Context) graph.Manager {
            g := ctx.Value(&graphKey)
            if g == nil {
                    return nil
            }

            return g.(graph.Manager)
    }
Code-Wiederverwendung maximieren: Controller
Abgesehen vom zuvor ausgeklammerten HarborCluster-Controller kombinieren alle Komponenten-Controller im Harbor-Operator direkt denselben Controller. Sie extrahieren die gemeinsame Logik aller Controller und verwenden dasselbe Run, dasselbe Reconcile. Wie wird das gemacht?
- Welche Logik wurde extrahiert?
- Wie werden Unterschiede behandelt?
- Was wurde geopfert?
Datenstrukturen
Die Implementierung der Schnittstelle durch den Controller ist, abgesehen von der Implementierung von Reconciler, nicht besonders interessant. Schauen wir uns zunächst die Datenstrukturdefinition des Controller an:
    type ResourceManager interface {
            AddResources(context.Context, resources.Resource) error
            NewEmpty(context.Context) resources.Resource
    }

    type Controller struct {
            client.Client

            BaseController controllers.Controller
            Version        string
            GitCommit      string

            ConfigStore *configstore.Store
            rm          ResourceManager
            Log         logr.Logger
            Scheme      *runtime.Scheme
    }
Die Dinge, die wir nicht kennen, sind nur BaseController und rm.
BaseController ist im Grunde ein Identifikator, der Informationen über den Controller selbst und einige Label-Informationen identifiziert. Die logischen Unterschiede zwischen verschiedenen Controllern können also nur in ResourceManager liegen. ResourceManager scheint ebenfalls eine sehr einfache Schnittstelle zu sein, und tatsächlich werden die konkreten Controller implementiert. Wir werden die konkreten Beispiele für ResourceManager am Ende untersuchen.
    type Controller int

    const (
       Core                Controller = iota // core
       JobService                            // jobservice
       Portal                                // portal
       Registry                              // registry
       RegistryController                    // registryctl
       ChartMuseum                           // chartmuseum
       Exporter                              // exporter
       NotaryServer                          // notaryserver
       NotarySigner                          // notarysigner
       Trivy                                 // trivy
       Harbor                                // harbor
       HarborCluster                         // harborcluster
       HarborConfiguration                   // harborconfiguration
    )

    func (c Controller) GetFQDN() string {
       return fmt.Sprintf("%s.goharbor.io", strings.ToLower(c.String()))
    }

    func (c Controller) Label(suffix ...string) string {
       return c.LabelWithPrefix("", suffix...)
    }

    func (c Controller) LabelWithPrefix(prefix string, suffix ...string) string {
       var suffixString string
       if len(suffix) > 0 {
          suffixString = "/" + strings.Join(suffix, "-")
       }

       if prefix != "" {
          prefix = "." + prefix
       }

       return fmt.Sprintf("%s%s%s", prefix, c.GetFQDN(), suffixString)
    }
Reconcile-Logik
Wie schafft es der Controller, mit nur einem Reconcile alle elf CRDs von Harbor zusammen mit so vielen Systemressourcen zu reconciliieren?
Basierend auf den bereits bekannten Informationen sollte für jede CRD ein ResourceManager verwendet werden, um die verschiedenen Ressourcen zu definieren, die diese CRD erstellen und reconciliieren muss. Diese Ressourcen definieren ihre Abhängigkeiten über den Abhängigkeitsgraphen, und für jede CRD wird eine konkrete RunFunc geschrieben, um die endgültige Regelung durchzuführen.
    func (c *Controller) Reconcile(req ctrl.Request) (ctrl.Result, error) {
       ctx := c.NewContext(req)

       span, ctx := opentracing.StartSpanFromContext(ctx, "reconcile", opentracing.Tags{
          "resource.namespace": req.Namespace,
          "resource.name":      req.Name,
          "controller":         c.GetName(),
       })
       defer span.Finish()

       l := logger.Get(ctx)

       // Fetch the instance

       object := c.rm.NewEmpty(ctx)

       ok, err := c.GetAndFilter(ctx, req.NamespacedName, object)
       if err != nil {
          // Error reading the object
          return ctrl.Result{}, err
       }

       if !ok {
          // Request object not found, could have been deleted after reconcile request.
          // Owned objects are automatically garbage collected. For additional cleanup logic use finalizers.
          l.Info("Object does not exists")

          return ctrl.Result{}, nil
       }

       if !object.GetDeletionTimestamp().IsZero() {
          logger.Get(ctx).Info("Object is being deleted")

          return ctrl.Result{}, nil
       }

       owner.Set(&ctx, object)

       if err := c.Run(ctx, object); err != nil {
          return c.HandleError(ctx, object, err)
       }

       return ctrl.Result{}, c.SetSuccessStatus(ctx, object)
    }
Klassische Reconcile-Logik. Es scheint, dass die Magie in c.Run steckt:
    func (c *Controller) Run(ctx context.Context, owner resources.Resource) error {
       span, ctx := opentracing.StartSpanFromContext(ctx, "run")
       defer span.Finish()

       logger.Get(ctx).V(1).Info("Reconciling object")

       if err := c.rm.AddResources(ctx, owner); err != nil {
          return errors.Wrap(err, "cannot add resources")
       }

       if err := c.PrepareStatus(ctx, owner); err != nil {
          return errors.Wrap(err, "cannot prepare owner status")
       }

       return sgraph.Get(ctx).Run(ctx)
    }
Tatsächlich taucht rm hier auf. Nachdem die für einen bestimmten Controller benötigten Ressourcen hinzugefügt wurden, scheint PrepareStatus einheitlich zu sein. Eine Kombination aus dem Quellcode dieser Methode und der CRD-Definition zeigt, dass davon ausgegangen wird, dass alle Komponenten denselben Status haben – wieder ein Design, das Flexibilität für Einfachheit und Konsistenz opfert. Tatsächlich folgt dieses Design den von K8s empfohlenen Konventionen und kann beim Entwerfen von CRDs als Referenz dienen. Darauf wird hier nicht weiter eingegangen.
Letzte Zeile: sgraph.Get(ctx).Run(ctx) – der Abhängigkeitsgraph kommt, aus dem Äther (ctx) geholt. Damit schließt sich der Kreis für diesen Teil der Logik. Die verbleibende Frage ist: Wie konstruieren die konkreten Controller, die ResourceManager implementieren, den Abhängigkeitsgraphen und ihre eigene RunFunc?
Code als Konfiguration: ResourceManager
Der letzte Schritt ergibt sich fast von selbst.
Alle Controller, die ResourceManager implementieren, sollten gleichberechtigt sein. Lassen Sie uns anhand des Beispiels harbor core einen Blick darauf werfen.
Abgesehen von den Teilen, die zur Erzeugung konkreter K8s-Ressourcen dienen, sollten wir uns auf die Teile konzentrieren, die die ResourceManager-Schnittstelle implementieren.
    func (r *Reconciler) NewEmpty(_ context.Context) resources.Resource {
       return &goharborv1.Core{}
    }

    func (r *Reconciler) AddResources(ctx context.Context, resource resources.Resource) error {
       core, ok := resource.(*goharborv1.Core)
       if !ok {
          return serrors.UnrecoverrableError(errors.Errorf("%+v", resource), serrors.OperatorReason, "unable to add resource")
       }

       service, err := r.GetService(ctx, core)
       if err != nil {
          return