Manueller Aufbau von Prometheus auf einem K8s Single-Node-Cluster
Die Zielgruppe dieses Artikels sind Personen, die gerade erst mit Monitoringsystemen in Berührung kommen, sowie die “benachteiligte Gruppe”, die wenig über Prometheus weiß (so wie der Autor zum Zeitpunkt der Abfassung dieses Artikels).
Die für den Aufbau von Prometheus in diesem Artikel verwendete Umgebung:
- K8s Version: 1.19.3
- Prometheus Version: 2.22.0
- Betriebssystem: Archlinux, Stand 2020.11
- Hosts konfiguriert, Domainname der Devbox ist
devbox⚠️ Bitte beachten: Die in diesem Artikel aufgeführten Kommandozeilenparameter müssen je nach aktueller Umgebung leicht angepasst werden (z.B. Version des Prometheus-Binärpakets usw.).
Hier sind einige empfohlene Vorab-Lektüren aufgelistet:
- Observability: Konzepte und Best Practices – stellt verschiedene grundlegende Konzepte der Observability vor.
- Erste Schritte mit Prometheus – stellt das Prometheus-Projekt vor.
- Die Einführung auf der offiziellen Prometheus-Website
Ziel
Da es um den manuellen Aufbau von Prometheus auf K8s geht, legen wir hier zwei Konventionen fest:
- Wir verzichten bewusst auf schnelle Bereitstellungsmethoden wie Helm-Charts oder den Prometheus Operator. Diese werden hier nur der Referenz halber aufgeführt:
- Der von der Prometheus-Community gepflegte Helm chart
- Prometheus Operator
- Kube-Prometheus
- Aufbau von Prometheus auf K8s, d.h. K8s ist für die Verwaltung des Prometheus-Dienstes verantwortlich. Im Gegensatz zum oben genannten Prometheus Operator werden wir hier die relevanten YAML-Konfigurationsdateien selbst schreiben.
- Folgende Monitoring-Ziele werden aufgelistet:
- Prometheus selbst
- Node Exporter
- Kubelet
- cAdvisor
- ApiServer
Dann legen wir los!
Proof of Concept: Prometheus auf Bare Metal
Zunächst liegt der erste Gedanke nahe, einen Proof of Concept auf Bare Metal durchzuführen. Erst einmal zum Laufen bringen, dann mit weiteren Konfigurationen experimentieren. Letztendlich, wenn wir die verschiedenen Konfigurationsoptionen von Prometheus verstanden haben, sollte die erneute Bereitstellung auf K8s ein Kinderspiel sein.
Ich wollte versuchen, faul zu sein. Nach der Suche nach Tutorial-Blogs stellte ich fest, dass diese unklar und größtenteils veraltet waren. Das Ergebnis war, dass ich einen halben Tag verschwendete und dann doch brav die Dokumentation auf der offiziellen Website lesen musste.
Prometheus installieren
Gemäß der Dokumentation wird das entsprechende vorkompilierte Binärpaket direkt hier heruntergeladen:
curl -LO "https://github.com/prometheus/prometheus/releases/download/v2.22.0/prometheus-2.22.0.linux-amd64.tar.gz"
tar -zxvf prometheus-2.22.0.linux-amd64.tar.gz
cd prometheus-2.22.0.linux-amd64
./prometheus --version
# Erwartete Ausgabe sollte so aussehen:
# prometheus, version 2.22.0 (branch: HEAD, revision: 0a7fdd3b76960808c3a91d92267c3d815c1bc354)
#  build user:    root@6321101b2c50
#  build date:    20201015-12:29:59
#  go version:    go1.15.3
#  platform:     linux/amd64
Ein Blick ins Verzeichnis zeigt, dass eine Konfigurationsdatei prometheus.yml enthalten ist:
# my global config
global:
  scrape_interval:     15s # Set the scrape interval to every 15 seconds. Default is every 1 minute.
  evaluation_interval: 15s # Evaluate rules every 15 seconds. The default is every 1 minute.
  # scrape_timeout is set to the global default (10s).

# Alertmanager configuration
alerting:
  alertmanagers:
  - static_configs:
    - targets:
      # - alertmanager:9093

# Load rules once and periodically evaluate them according to the global 'evaluation_interval'.
rule_files:
  # - "first_rules.yml"
  # - "second_rules.yml"

# A scrape configuration containing exactly one endpoint to scrape:
# Here it's Prometheus itself.
scrape_configs:
  # The job name is added as a label `job=<job_name>` to any timeseries scraped from this config.
  - job_name: 'prometheus'
    # metrics_path defaults to '/metrics'
    # scheme defaults to 'http'.
    static_configs:
    - targets: ['localhost:9090']
Jetzt starten wir den gerade heruntergeladenen Prometheus, um sich selbst zu überwachen, und erhalten eine kleine, befriedigende Feedback-Schleife:
./prometheus --config.file=prometheus.yml
Man sieht, dass Prometheus nun gestartet ist. Unter http://devbox:9090 ist die Benutzeroberfläche erreichbar. Durch zufälliges Klicken kann man ein grobes Gefühl für die von Prometheus bereitgestellten Funktionen bekommen und ein Verständnis dafür entwickeln, wie sich Prometheus im normalen Betrieb verhält.
Node Exporter ausführen
Jetzt führen wir einen Node Exporter auf Bare Metal aus, um verschiedene Metriken der lokalen Maschine zu beobachten.
curl -LO "https://github.com/prometheus/node_exporter/releases/download/v1.0.1/node_exporter-1.0.1.linux-amd64.tar.gz"
tar -zxvf node_exporter-1.0.1.linux-amd64.tar.gz
cd node_exporter-1.0.1.linux-amd64
./node_exporter
Als nächstes passen wir die Konfiguration an, damit Prometheus Metriken daraus sammelt.
# my global config
global:
  scrape_interval:     15s # Set the scrape interval to every 15 seconds. Default is every 1 minute.
  evaluation_interval: 15s # Evaluate rules every 15 seconds. The default is every 1 minute.
  # scrape_timeout is set to the global default (10s).

# A scrape configuration containing exactly one endpoint to scrape:
# Here it's Prometheus itself.
scrape_configs:
  # The job name is added as a label `job=<job_name>` to any timeseries scraped from this config.
  - job_name: 'prometheus'
    # metrics_path defaults to '/metrics'
    # scheme defaults to 'http'.
    static_configs:
    - targets: ['localhost:9090']
  - job_name: 'node-exporter'
    static_configs:
    - targets: ['localhost:9100']
Öffnen Sie die Prometheus-Web-UI und beobachten Sie, dass ein neues Target namens node-exporter hinzugefügt wurde. Prüfen Sie die Auslastung (es läuft ein Programm, das alle Kerne mit einer endlosen Fibonacci-Berechnung auslastet, hier):
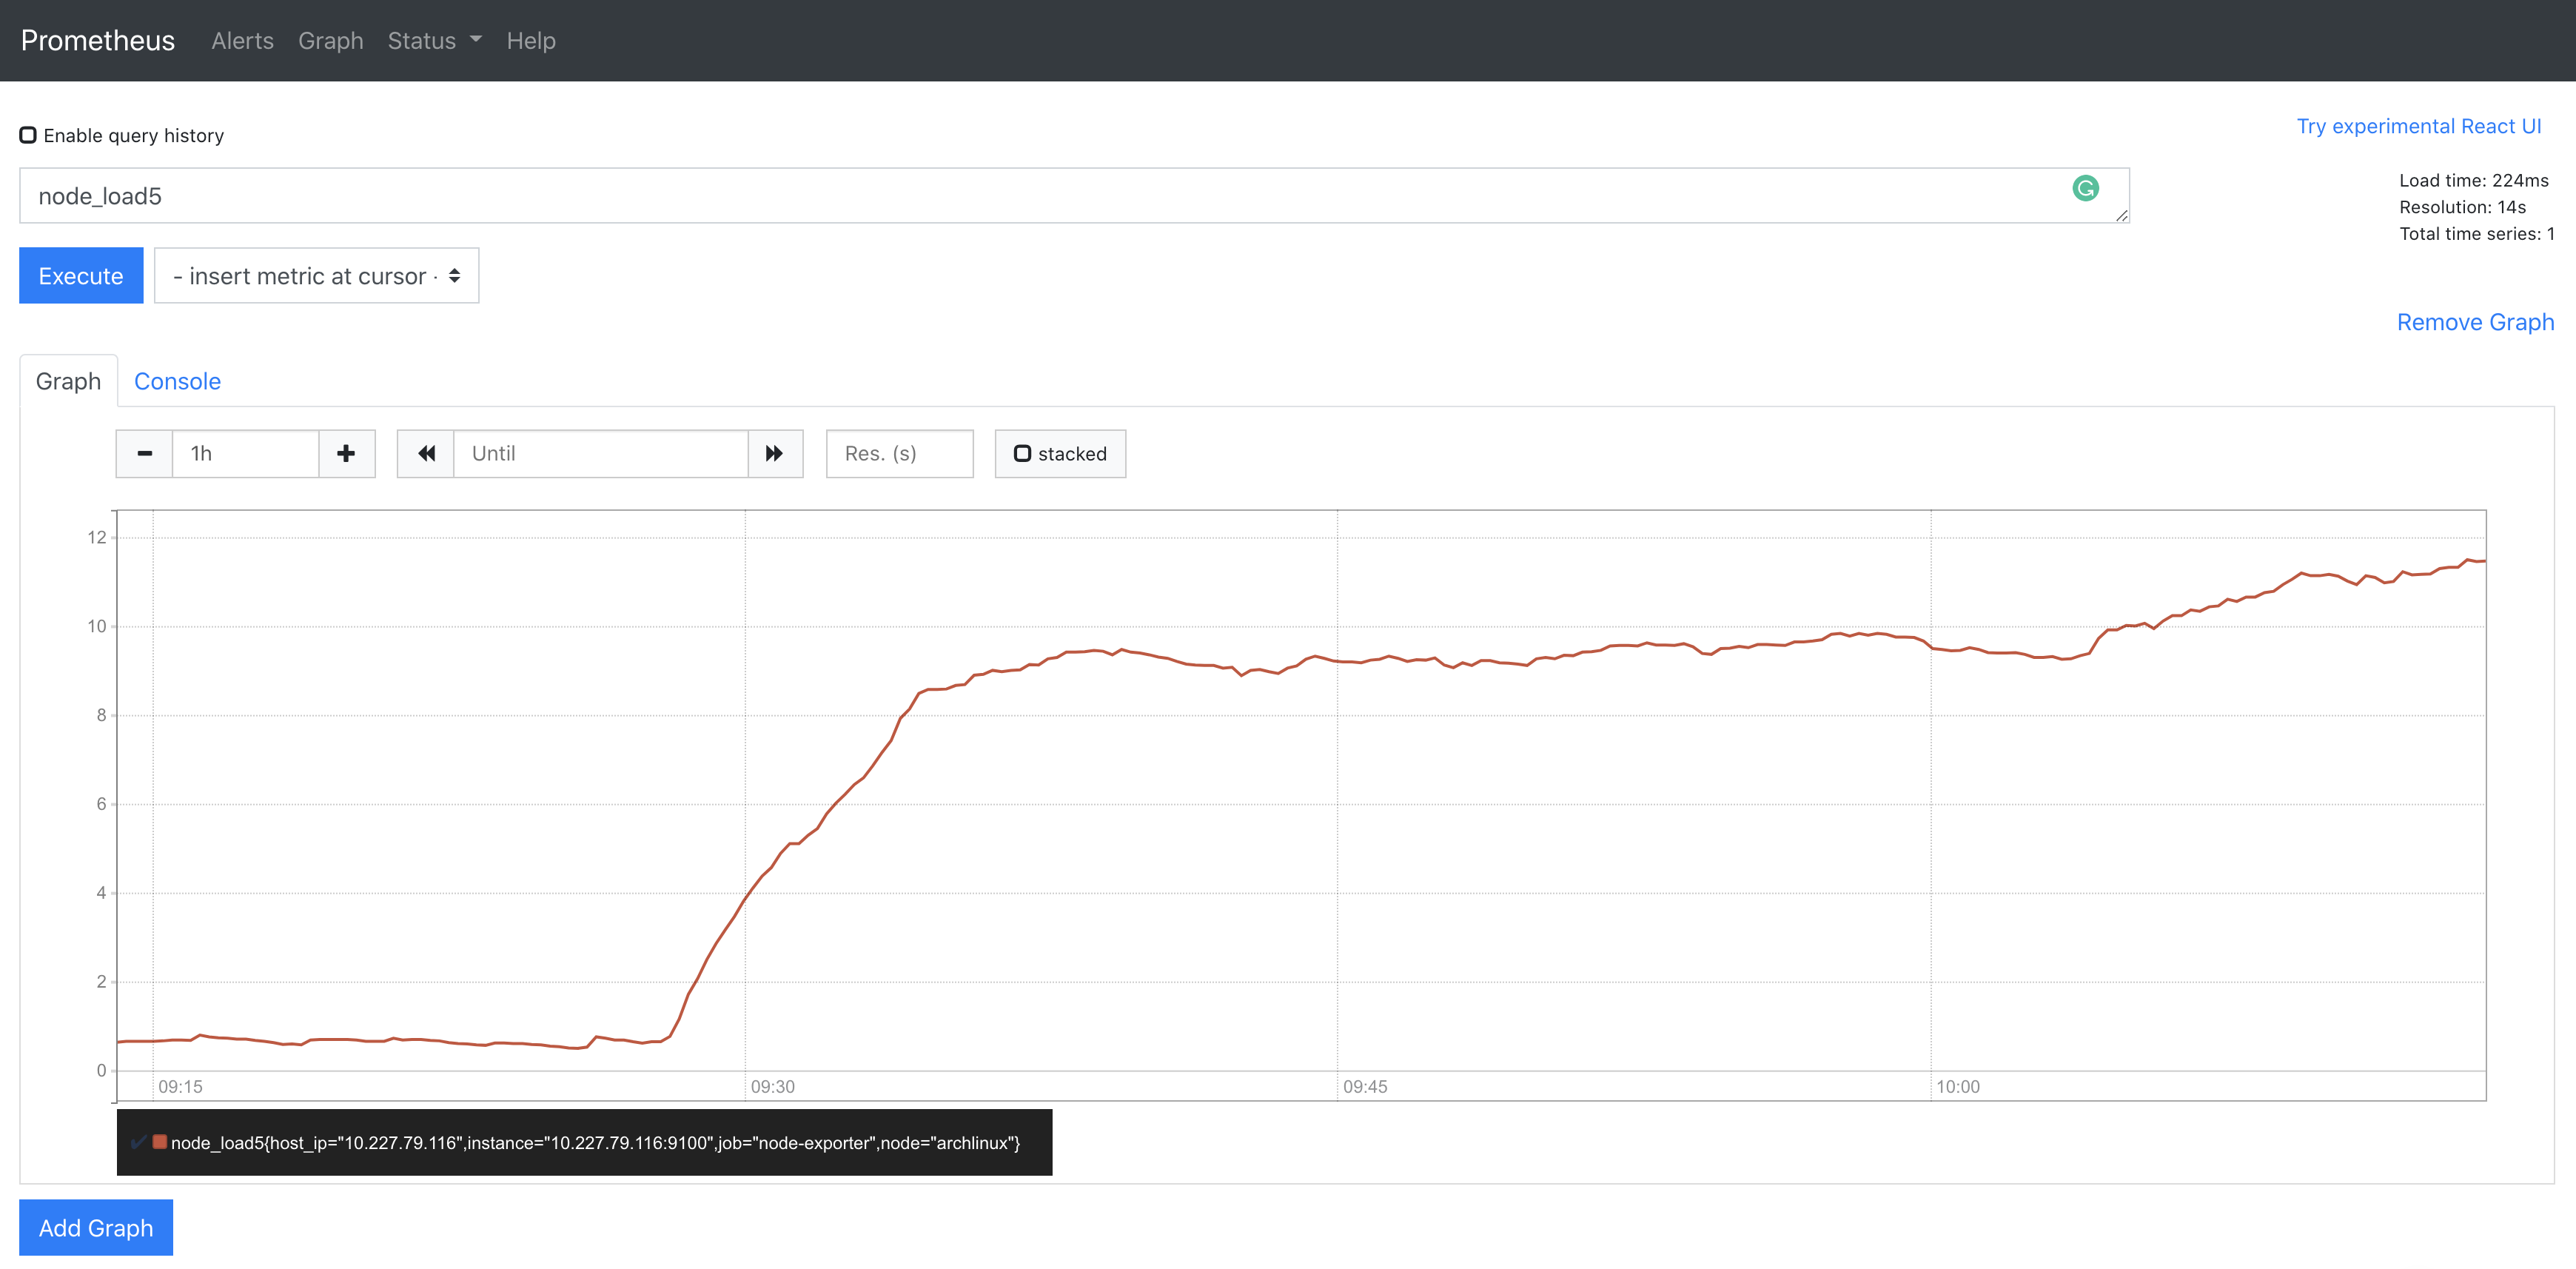
Damit ist die Proof-of-Concept-Phase erfolgreich abgeschlossen.
Hinweis: Als Proof of Concept wird hier nicht empfohlen, den auf Bare Metal bereitgestellten Prometheus direkt zur Überwachung des K8s-Clusters zu verwenden. Der Grund dafür ist, dass der Zugriff auf K8s-Komponenten von außerhalb des Clusters die Konfiguration von Zertifikaten und einen ClusterRole mit entsprechenden Zugriffsberechtigungen erfordert (hier werden die verschiedenen Fallstricke weggelassen, die der Autor erlebt hat, als er unbedingt versuchte, den auf Bare Metal bereitgestellten Prometheus zur Überwachung des K8s-Clusters und seiner Komponenten zu verwenden).
Überwachung des K8s-Clusters mit Prometheus
Als nächstes wollen wir unseren K8s-Cluster über Prometheus überwachen.
Konfigurationsoptionen von Prometheus
Aus der Einführung zu Prometheus geht hervor, dass Prometheus hauptsächlich auf Pull-basierter Datenerfassung basiert. Daher ist Service Discovery erforderlich, d.h. Prometheus muss wissen, woher es Daten abrufen kann, damit der Benutzer sie einsehen kann.
Die erste zu lösende Frage ist also: Service Discovery für den K8s-Cluster – das Geheimnis muss in der Konfiguration verborgen sein.
In der Dokumentation finden Sie eine detaillierte Beschreibung der Prometheus-Konfiguration.
Einige dieser Konfigurationselemente werden kurz beschrieben (sie sind nicht unbedingt orthogonal zueinander):
<global>: Die darin enthaltenen Konfigurationen wirken sich auf alle anderen Konfigurationselemente aus und dienen als Standardwerte für Elemente in anderen Konfigurationen.<scrape_config>: Definiert einen Überwachungsjob und beschreibt, woher und wie Prometheus dieses Ziel überwachen soll.<tls_config>: Beschreibt die TLS-Konfiguration.<*_sd_config>: Prometheus bietet mit dieser Reihe von Konfigurationselementen die Konfiguration für die Service Discovery einer Reihe vordefinierter Überwachungsziele (sd steht für Service Discovery).<static_config>: Für Überwachungsziele, die von Prometheus nicht vordefiniert sind (z.B. beliebige manuell auf Bare Metal bereitgestellte Dienste), kann dieses Konfigurationselement für die Service Discovery verwendet werden. Im Proof of Concept oben haben wir dieses Konfigurationselement verwendet.<relabel_config>: Bevor mit dem Abruf der Metriken der Überwachungsziele begonnen wird, können mit diesem Konfigurationselement einige Labels geändert werden. Prometheus bietet einige vordefinierte Label-Regeln. Relabeling kann in mehreren Schritten erfolgen. Nach Abschluss des Relabelings werden Labels mit dem Präfix__gelöscht.
Es scheint, dass das Kernkonfigurationselement in Prometheus <scrape_config> ist. Jedes definiert einen Überwachungsjob, ähnlich einem Namespace, und bietet hauptsächlich eine Aggregation von Überwachungszielen. Darin teilen wir Prometheus durch die Definition von <*_sd_config> oder <static_config> mit, von welchen Endpunkten genau Daten abgerufen werden sollen und wie diese Endpunkte gefiltert werden sollen.
Vertiefen wir unser Verständnis dieser Konfigurationselemente durch praktische Übungen!
Bereitstellung von Prometheus
Die Kernarbeit bei der Bereitstellung besteht darin, genau zu überlegen, welche Ressourcen für die Bereitstellung von Prometheus im Cluster benötigt werden. Der Autor verrät die Antwort direkt hier:
- Einen dedizierten Namespace
- Ein DaemonSet zur Verwaltung von node-exporter
- Node-exporter Service
- Verwaltung der Prometheus-Konfiguration mit ConfigMap
- Ein dediziertes ServiceAccount für Prometheus
- Ein ClusterRole mit ausreichenden Berechtigungen
- Ein ClusterRoleBinding, das ServiceAccount und ClusterRole verbindet
- Prometheus Deployment
- Prometheus Service
In einem K8s-Cluster mit aktiviertem RBAC müssen wir für Prometheus eine Rolle mit ausreichenden Berechtigungen definieren, die den Clusterstatus und verschiedene Metriken lesen kann. Daher sind die Punkte 5-7 erforderlich.
Hier ist eine Sammlung von Ressourcendeklarationen, die der Autor während seines eigenen Aufbaus gesammelt hat. Neben den oben genannten Ressourcen enthält sie auch kube-state-metrics. Wenn Sie in der angegebenen Reihenfolge vorgehen, erhalten Sie einen bereitgestellten Prometheus.
Node-exporter
Für den Node-exporter, der die Maschine selbst überwacht, ist die Anforderung: einer pro Node. Da wir gleichzeitig die Lebenszyklusverwaltung von K8s nutzen möchten, ist DaemonSet die beste Wahl.
Da er in einem Container läuft, kann er ohne Konfiguration keine echten Node-Metriken sammeln. Daher müssen spezielle Orte des Hosts im Container gemountet werden, damit der Node-exporter Metriken sammeln kann.
args:
  - '--path.procfs=/host/proc'
  - '--path.sysfs=/host/sys'
  - '--path.rootfs=/host/root'
volumes:
  - hostPath:
      path: /proc
    name: proc
  - hostPath:
      path: /sys
    name: sys
  - hostPath:
      path: /
    name: root
Dann wird über einen Service ein Endpunkt verfügbar gemacht, auf den Prometheus dauerhaft zugreifen kann.
Prometheus
Prometheus wird mit einem Deployment bereitgestellt. Vor der Bereitstellung von Prometheus muss ihm ausreichende Berechtigung konfiguriert werden, damit es auf die notwendigen Endpunkte zum Sammeln von Metriken zugreifen kann. In einem K8s-Cluster mit konfiguriertem RBAC wird dies über ClusterRole/ServiceAccount/ClusterRoleBinding erreicht. Nach Abschluss der Konfiguration authentifiziert sich Prometheus über den ServiceAccount, um auf die benötigten Endpunkte zuzugreifen.
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  name: prometheus
  labels:
    app.kubernetes.io/name: prometheus
rules:
  - apiGroups: [""]
    resources:
      - nodes
      - nodes/metrics
      - services
      - endpoints
      - pods
    verbs: ["get", "list", "watch"]
  - nonResourceURLs:
      - "/metrics"
      - "/metrics/cadvisor"
    verbs: ["get"]
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: default
  namespace: monitoring-system
  labels:
    app.kubernetes.io/name: prometheus
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRoleBinding
metadata:
  name: prometheus
  labels:
    app.kubernetes.io/name: prometheus
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: ClusterRole
  name: prometheus
subjects:
  - kind: ServiceAccount
    name: default
    namespace: monitoring-system
Bis jetzt haben wir alle Voraussetzungen geschaffen, um unsere Überwachungsziele zu erreichen. Aber wie treiben wir nun die mächtige Prometheus-Engine an, um unsere Umgebung optimal zu nutzen und die Überwachung zu realisieren?
In Kombination mit der vorherigen Einführung in die Prometheus-Konfiguration werden die vier Überwachungsziele mit vier <scrape_config>-Definitionen umgesetzt:
Für node-exporter:
- job_name: 'node-exporter'
  kubernetes_sd_configs:
    - role: endpoints
  relabel_configs:
    - source_labels: [__meta_kubernetes_service_name]
      regex: node-exporter
      action: keep
    - source_labels: [__meta_kubernetes_endpoint_node_name]
      target_label: node
    - source_labels: [__meta_kubernetes_pod_host_ip]
      target_label: host_ip
Da es sich um einen Cluster-internen Zugriff handelt, ist keine zusätzliche Authentifizierung erforderlich, und HTTPS-Zugriff muss nicht aktiviert werden.
Hier wird <relabel_configs> am Beispiel von node-exporter weiter erläutert:
Ein Label ist eine Eigenschaft eines bestimmten Endpunkts. Unterschiedliche Endpunkte können unter demselben Label unterschiedliche Werte haben. Was <relabel_config> tut, ist, Operationen wie Ändern und Filtern auf diesen Labels durchzuführen, damit wir die gewünschten Endpunkte filtern/modifizieren können.
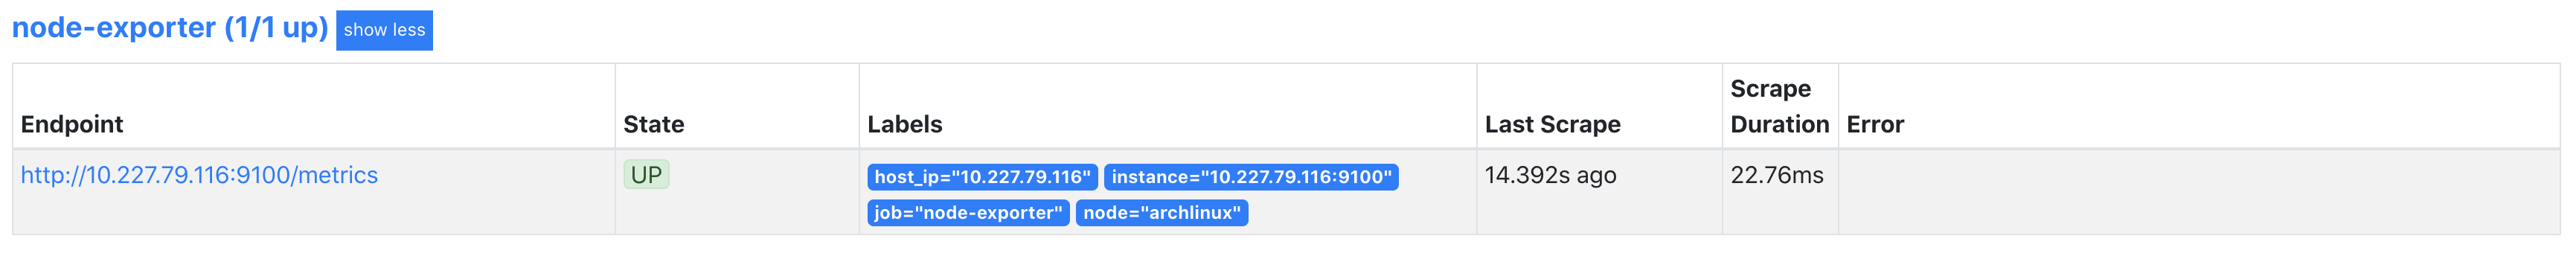
Wie man sieht, gibt es in der obigen Konfiguration drei Relabel-Aktionen. Die erste bedeutet: Aus allen Werten des von der K8s-Service-Discovery vordefinierten Labels __meta_kubernetes_service_name werden gemäß dem angegebenen regulären Ausdruck “node-exporter” gefiltert. Gemäß der action werden die übereinstimmenden Zielendpunkte beibehalten, die restlichen Werte mit demselben Label werden verworfen. Die beiden folgenden Relabel-Aktionen dienen dazu, die semantischen Labels node und host_ip durch Umbenennung beizubehalten. (Erinnern Sie sich? Labels, die mit einem doppelten Unterstrich beginnen, werden am Ende gelöscht.)
Für Prometheus selbst:
- job_name: 'prometheus'
  kubernetes_sd_configs:
    - role: endpoints
  relabel_configs:
    - source_labels: [__meta_kubernetes_service_name]
      regex: prometheus
      action: keep
Verwenden Sie den gleichen Ansatz, um die Endpunkte herauszufiltern.
Für Kubelet und cAdvisor wird die Situation etwas komplexer:
- job_name: 'kubelet'
  kubernetes_sd_configs:
    - role: node
  tls_config:
    # ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crt
    # cert_file: /etc/secret/cert
    # key_file: /etc/secret/key
    insecure_skip_verify: true
  bearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/token
  scheme: https
- job_name: 'cadvisor'
  kubernetes_sd_configs:
    - role: node
  metrics_path: /metrics/cadvisor
  tls_config:
    # ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crt
    # cert_file: /etc/secret/cert
    # key_file: /etc/secret/key
    insecure_skip_verify: true
  bearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/token
  scheme: https
Beachten Sie, dass die Rolle node ist. Daher ruft Prometheus standardmäßig Metriken von <node_ip>:10250/metrics ab. Hier gibt es eine zusätzliche Konfigurationsoption bearer_token_file. Da Kubelet standardmäßig keinen anonymen Zugriff auf seine Metrikdaten erlaubt, kommt hier der zuvor konfigurierte ServiceAccount zum Einsatz. Der Einfachheit halber verwenden wir insecure_skip_verify: true, um die TLS-Authentifizierung zu umgehen.
Für den ApiServer wird es wieder etwas komplexer:
scrape_configs:
- job_name: 'kubernetes-apiservers'
  kubernetes_sd_configs:
    - role: endpoints
  scheme: https
  tls_config:
    ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crt
  bearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/token
  relabel_configs:
    - source_labels: [__meta_kubernetes_namespace, __meta_kubernetes_service_name, __meta_kubernetes_endpoint_port_name]
      action: keep
      regex: default;kubernetes;https
Hier filtern wir mit <relabel_config> die Endpunkte des ApiServers selbst heraus. Neben der Token-Authentifizierung muss auch eine CA-Datei zur Identitätsüberprüfung bereitgestellt werden. So können wir auf den ApiServer zugreifen.
Damit haben wir die Bereitstellung von Prometheus und die Konfiguration der Überwachung der Zielendpunkte abgeschlossen.
Interessierte Leser können die Konfiguration weiter anpassen, um das Verhalten von Prometheus unter verschiedenen Konfigurationen zu beobachten und ihr Verständnis zu vertiefen. Hier eine kleine Aufgabe: Wie können wir einen K8s-Cluster mit einem auf Bare Metal bereitgestellten Prometheus überwachen?