Lectura del Código Fuente: Harbor-Operator
Preparativos Iniciales
¿Por qué Harbor-Operator?
¿Worse is Better?
¿Qué es un buen software?
En un famoso artículo de finales de los 80, The Rise of Worse is Better, el autor menciona que un buen diseño de software debe considerar cuatro cualidades: simplicidad, corrección, consistencia y integridad.
El autor describe dos filosofías de diseño de software, llamémoslas the right thing y worse is better (es necesario señalar que este nombre no es peyorativo); ambas filosofías giran en torno a las cuatro cualidades mencionadas, diferenciándose en la priorización de estas.
The right thing
- Simplicidad - El diseño debe ser simple y fácil de entender. La simplicidad de la interfaz es más importante que la simplicidad de la implementación.
- Corrección - El diseño debe ser correcto. No se pueden hacer concesiones en este punto.
- Consistencia - La consistencia es tan importante como la corrección. Por lo tanto, se puede ceder un poco en simplicidad e integridad.
- Integridad - El diseño debe poder considerar una amplia variedad de situaciones posibles. No se puede sacrificar excesivamente la integridad para mantener la simplicidad.
Worse is better
- Simplicidad - El diseño debe ser simple y fácil de entender. La simplicidad de la implementación es más importante que la simplicidad de la interfaz. La simplicidad es la cualidad más importante.
- Corrección - El diseño debe ser correcto, por supuesto, pero mantener la simplicidad es un poco más importante que la corrección.
- Consistencia - El diseño no debe ser demasiado inconsistente. Se puede sacrificar la consistencia para mantener la simplicidad. Se puede sacrificar la consistencia por integridad, siempre que se garantice la simplicidad.
- Integridad - El diseño debe poder considerar una amplia variedad de situaciones posibles. Se puede sacrificar la integridad en cualquier momento para garantizar la simplicidad del diseño.
Posteriormente, el autor da muchos ejemplos de ambas filosofías para argumentar por qué worse-is-better estaba arrasando en la industria del software de la época.
Estas dos filosofías no tienen una superioridad inherente. Hoy en día, las encontramos a nuestro alrededor, y la realidad a menudo oscila entre ambas. Aspiramos a crear diseños excelentes, con valor estético, pero también debemos considerar factores de costo y humanos. Al final, debemos entregar software de calidad que funcione para resolver problemas del mundo real, y el costo de escribir y mantener el software absolutamente no puede ser mayor que el valor del problema en sí.
Golang - el lenguaje
Golang es casi el ejemplo por excelencia de la filosofía worse is better:
- Condensa años de experiencia práctica de Google con C++.
- Es tan simple, sin características complejas, que básicamente solo hay una forma de construir bloques para resolver un problema. Esto significa:
- Casi no se necesita esfuerzo para dominar el lenguaje en sí.
- El código es extremadamente legible.
- Compilación rápida, incluso sacrificó los genéricos por la velocidad de compilación.
- Es muy fácil ejecutar tareas en paralelo mediante goroutines.
- Casi descarta la característica del lenguaje de pila de excepciones, forzando la verificación y manejo de errores.
- Compila una vez, ejecuta en cualquier lugar.
Kubernetes - la plataforma
Kubernetes es familiar para todos, así que no me extenderé demasiado. En resumen: proporciona un diseño de API conceptualmente muy simple, complementado con un mecanismo de reconciliación inspirado en la cibernética, que permite la implementación, escalado y operación automatizada de software contenerizado.
K8s permite a los desarrolladores extender sus capacidades abriendo esta especificación de API y el mecanismo de reconciliación. Los desarrolladores pueden implementar el Patrón Operator: codificar el conocimiento de configuración, implementación (Día-1) y operación, respaldo, conmutación por error (Día-2) del software en un software que opera el software, automatizando estas operaciones complejas y propensas a errores, mejorando así la confiabilidad y reduciendo costos.
Entonces, la razón para elegir Harbor Operator es que posee un diseño excepcional. En una plataforma excelente y utilizando características de un lenguaje simple, sin trucos excesivos, logra, a través de unos pocos diseños clave que siguen los principios SOLID, implementar un sistema de software pragmático y con valor estético, que puede considerarse un practicante de la filosofía the right thing.
El código del autor tiene casi ningún comentario, pero es excepcionalmente legible, lo que también se debe a la coherencia de todo el sistema.
Objetivos
La abstracción y simplificación de problemas inevitablemente conlleva una pérdida de flexibilidad. Harbor Operator, sin embargo, sacrifica completamente la flexibilidad para lograr la máxima reducción de carga mental, haciendo que el desarrollo del Operator se asemeje más a declarar una configuración de software.
Escribir un operator a mano con client-go, debido a la falta de genéricos en Golang, es casi un suplicio. El proyecto estaría plagado de una enorme cantidad de boilerplate code (código repetitivo). Creo que incluso si alguien realmente escribiera un operator a mano con client-go, nadie empezaría realmente desde cero.
Así nació kubebuilder. Abstrae operaciones como la creación del cliente de Kubernetes, la escucha de solicitudes del API Server de Kubernetes y su puesta en cola en bibliotecas comunes (controller runtime) y herramientas comunes (controller tools), y puede generar código de andamiaje para que los desarrolladores se centren en desarrollar la lógica de negocio para manejar cambios en los objetos de la API.
Kubebuilder aún deja un espacio para la diversidad de la lógica de negocio. Harbor Operator, sobre esta base, busca llevar las cosas al extremo, sacrificando completamente la flexibilidad en pos de la consistencia y simplicidad conceptual, y el negocio al que se enfrenta es realmente adecuado para este enfoque.
Por lo tanto, en esta lectura del código fuente, nuestro objetivo principal es aprender de Harbor Operator:
- Cómo realiza las operaciones del Día-1.
- Cómo reducir aún más la redundancia en el código del operator, utilizando el mismo código de Controller para implementar los Controllers de once CRDs diferentes en distintos niveles.
- Cómo utiliza un DAG para resolver las dependencias entre recursos (el autor parece haber patentado esto).
Además, no nos centraremos en:
- Las operaciones del Día-2 en Harbor Operator (de hecho, en la versión actual esta funcionalidad aún no es estable).
- El código fuente y las funcionalidades del propio Harbor.
Lectura del Código Fuente
Estructura Estática
Estructura de Directorios
Aquí solo se listan los directorios.
    root
    ├── apis
    │   ├── goharbor.io
    │   │   └── v1alpha3
    │   └── meta
    │       └── v1alpha1
    ├── controllers
    │   ├── controller_string.go
    │   ├── controllers.go
    │   └── goharbor
    │       ├── chartmuseum
    │       ├── controller_test.go
    │       ├── core
    │       ├── exporter
    │       ├── harbor
    │       ├── harborcluster
    │       ├── internal
    │       ├── jobservice
    │       ├── notaryserver
    │       ├── notarysigner
    │       ├── portal
    │       ├── registry
    │       ├── registryctl
    │       └── trivy
    ├── pkg
    │   ├── builder
    │   ├── cluster
    │   │   ├── controllers
    │   │   │   ├── cache
    │   │   │   ├── common
    │   │   │   ├── database
    │   │   │   │   └── api
    │   │   │   ├── harbor
    │   │   │   └── storage
    │   │   ├── gos
    │   │   ├── k8s
    │   │   └── lcm
    │   ├── config
    │   │   ├── harbor
    │   │   └── template
    │   ├── controller
    │   │   ├── errors
    │   │   ├── internal
    │   │   └── graph
    │   │   └── mutation
    │   ├── event-filter
    │   ├── exit
    │   ├── factories
    │   │   ├── application
    │   │   ├── logger
    │   │   └── owner
    │   ├── graph
    │   ├── harbor
    │   ├── image
    │   ├── manager
    │   ├── resources
    │   │   ├── checksum
    │   │   └── statuscheck
    │   ├── scheme
    │   ├── setup
    │   ├── status
    │   ├── template
    │   ├── tracing
    │   ├── utils
    │   │   └── strings
    │   └── version
    ...
Interfaces Clave

Arquitectura del Sistema
Hasta la versión v1.0.1, Harbor Operator se encarga principalmente de las operaciones del Día-1 del sistema Harbor. 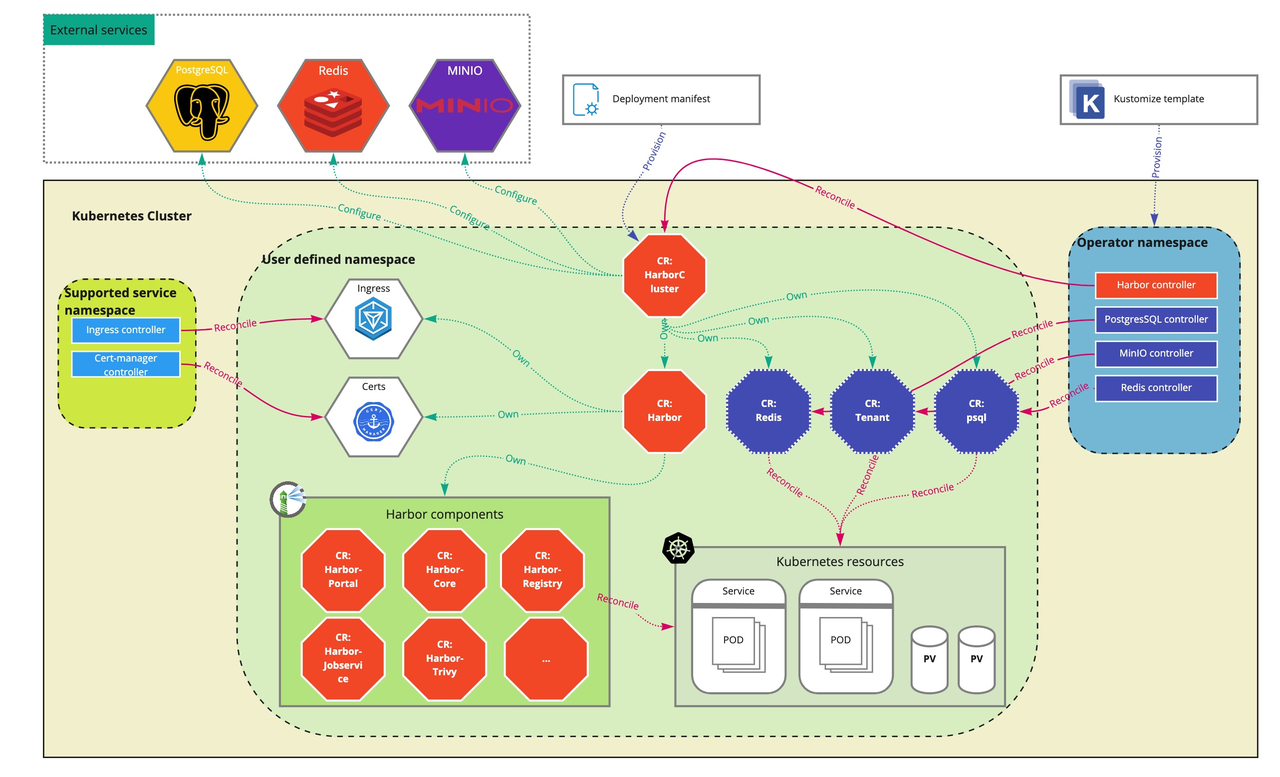
Enfocarse en lo Esencial: HarborCluster
Primero, filtremos algunas partes no tan críticas: la definición del CRD HarborCluster y la implementación de su Controller.
¿Por qué es especial? Observemos primero su posición en la arquitectura del sistema: está en el nivel más alto. Gestiona el propio sistema Harbor y todos los servicios con estado de los que depende. Esto requiere explicación desde dos aspectos: la historia del proyecto y su posición especial en la arquitectura del sistema.
Desde la perspectiva de la arquitectura del sistema, este CRD HarborCluster es extremadamente similar en definición al CRD Harbor, con una gran cantidad de redundancia en el código, lo que lo hace visualmente poco atractivo. Esto se debe a que, como el CRD más externo (superior) del sistema, está orientado directamente al usuario; debe poder proporcionar al usuario todas las configuraciones necesarias para declarar una implementación de Harbor. Además, dado que Harbor en sí es un conjunto de servicios sin estado, una implementación completa también requiere que el CRD HarborCluster gestione todos los servicios con estado de los que depende Harbor, incluyendo Postgres, Minio y Redis.
La información necesaria del propio sistema Harbor ya está definida en el CRD Harbor. Por lo tanto, la parte redundante en el CRD HarborCluster es transmitir esta información completa y correctamente al CRD Harbor. Además, el CRD HarborCluster necesita gestionar los CRDs de esos servicios con estado que están fuera de su propio límite de responsabilidad, por lo que no puede utilizar completamente la lógica del Controller de Harbor y todos sus subcomponentes.
Desde una perspectiva histórica, Harbor Operator fue originalmente un proyecto privado de OVH Cloud, que luego fue donado a la comunidad goharbor. Por lo tanto, observando el historial de git, la razón por la cual la definición del CRD HarborCluster y la implementación de su Controller tienen tanta inconsistencia con otros Controllers en el sistema es que fue un aporte posterior de la comunidad. En el diseño inicial de Harbor Operator no se consideraron las funciones que debía asumir.
El Controller de HarborCluster en sí se implementa de manera similar a la mayoría de los Controllers que vemos comúnmente usando Controller-runtime, por lo que no lo estudiaremos en detalle.
Controller de HarborCluster

Controller de Harbor Core

Resolviendo Dependencias entre Recursos: Dependency Graph
El gráfico de dependencias es un módulo relativamente independiente en todo el proyecto, pero en realidad actúa como el motor de ejecución de todos los controllers en Harbor Operator. Esencialmente, se observa que existen relaciones de dependencia mutua entre varios tipos de recursos en Kubernetes. El despliegue y reconciliación de algunos recursos depende del despliegue y reconciliación de otros, por ejemplo, un Deployment puede depender de un ConfigMap; eventualmente, estas relaciones de dependencia forman un gráfico de dependencias, que en realidad debería ser un DAG (Grafo Acíclico Dirigido). Aquí necesitamos una definición de interfaz como la siguiente:
    package graph

    type Resource interface{}

    type RunFunc func(context.Context, Resource) error

    type Manager interface {
            Run(ctx context.Context) error
            AddResource(ctx context.Context, resource Resource, blockers []Resource, run RunFunc) error
    }

    type resourceManager struct {
       resources map[Resource][]Resource
       functions map[Resource]RunFunc

       lock sync.Mutex
    }
Resourcedefine un recurso abstracto. Dado que este módulo no se preocupa por lo que representa un recurso, y para maximizar la flexibilidad dentro de las limitaciones expresivas del lenguaje, se utiliza el tipo superiorinterface{}.RunFunces responsable de manejar específicamente cómo operar sobre unResource. Aquí,RunFuncenfrenta un problema de seguridad de tipos:interface{}significa que el compilador no sabe nada sobre este tipo, por lo que no puede proceder. PeroRunFuncdebe tomar este tipo que puede ser cualquier cosa y hacer algo con él. Por lo tanto, consideramos que debe realizar una conversión de tipo forzada. Si cadaRunFuncde recurso tuviera que convertir manualmente a un tipo específico, sería muy tedioso y desagradable; más adelante veremos cómo Harbor Operator centraliza este trabajo sucio en un solo lugar.Managersolo tiene dos métodos: agregar unResourcey ejecutar el gráfico. Necesitamos estudiarlos por separado.- La estructura de datos
resourceManagerque implementaManagertambién es simple:- Un mapa
resource -> blockers - Un mapa
resource -> runFunc - Un
lockpara manejar la concurrencia en las operaciones del mapa. De aquí podemos ver que al autor no le gustan las estructuras de datos comoSync.Mapque garantizan seguridad concurrente pero pierden seguridad de tipos. Esto hace que sea aún más curioso cómo maneja el autor tantosRunFunc(11 componentes).
- Un mapa
Si es un Graph, debe haber una estructura de datos para el Graph y un método de fábrica para construirlo. La estructura de datos de resourceManager parece un poco rígida, no estoy seguro de si es el Graph real.
AddResource
Según la firma, se puede observar que AddResource agrega el recurso en sí que necesita ser agregado, todas sus dependencias y la runFunc correspondiente. Vale la pena notar que primero se deben agregar los recursos que no dependen de ningún otro recurso (es decir, con grado de salida 0).
    func (rm *resourceManager) AddResource(ctx context.Context, resource Resource, blockers []Resource, run RunFunc) error {
       if resource == nil {
          return nil
       }

       if run == nil {
          return errors.Errorf("unsupported RunFunc value %v", run)
       }

       span, _ := opentracing.StartSpanFromContext(ctx, "addResource", opentracing.Tags{
          "Resource": resource,
       })
       defer span.Finish()

       nonNilBlockers := []Resource{}

       for _, blocker := range blockers {
          if blocker == nil {
             continue
          }

          nonNilBlockers = append(nonNilBlockers, blocker)

          _, ok := rm.resources[blocker]
          if !ok {
             return errors.Errorf("unknown blocker %+v", blocker)
          }
       }

       rm.lock.Lock()
       defer rm.lock.Unlock()

       _, ok := rm.resources[resource]
       if ok {
          return errors.Errorf("resource %+v already added", resource)
       }

       rm.resources[resource] = nonNilBlockers
       rm.functions[resource] = run

       return nil
    }
Run
Casi toda la lógica importante en este paquete está en el método Run. Primero veamos su primera mitad:
    func (rm *resourceManager) Run(ctx context.Context) error {
       span, ctx := opentracing.StartSpanFromContext(ctx, "walkGraph", opentracing.Tags{
          "Nodes.count": len(rm.resources),
       })
       defer span.Finish()

       g := errgroup.Group{}
       l := logger.Get(ctx)

       for _, no := range rm.getGraph(ctx) {
       ...
¡Ahí está! getGraph, parece que va a construir el graph. Al entrar, descubrimos que efectivamente resourceManager es solo un constructor, el graph real está escondido aquí, expresado como una lista de adyacencia. A primera vista, incluso parece complejo:
    type node struct {
       resource Resource
       fn       RunFunc

       parent      chan error
       parentLock  *sync.Mutex
       parentCount int

       children     []chan<- error
       childrenLock []*sync.Mutex
    }

    func (no *node) Wait(ctx context.Context) error {...}
    func (no *node) Terminates(err error) (result error) {...}
    func (no *node) AddChild(child *node) {...}
¿Por qué parent y children son un channel? ¿Por qué se necesitan tantos locks? Observemos el proceso de construcción del graph:
    func (rm *resourceManager) getGraph(ctx context.Context) []*node {
       span, _ := opentracing.StartSpanFromContext(ctx, "getGraph")
       defer span.Finish()

       rm.lock.Lock()
       defer rm.lock.Unlock()

       graph := make(map[Resource]*node, len(rm.resources))
       result := make([]*node, len(rm.resources))

       i := 0

       for resource, blockers := range rm.resources {
          blockerCount := len(blockers)

          node := &node{
             resource: resource,
             fn:       rm.functions[resource],

             parent:      make(chan error, blockerCount),
             parentLock:  &sync.Mutex{},
             parentCount: blockerCount,

             children:     []chan<- error{},
             childrenLock: []*sync.Mutex{},
          }
          graph[resource] = node
          result[i] = node

          i++

          blockers := blockers

          defer func() {
             for _, blocker := range blockers {
                graph[blocker].AddChild(node)
             }
          }()
       }

       return result
    }
¡Resulta que la relación de dependencia se invierte! Ahora, el recurso del que se depende apunta al dependiente. Para cada recurso, se construye un node. Al mismo tiempo, para cada dependencia del recurso, se agrega el parent chan de este recurso a los children del recurso del que depende. El graph final es una colección de nodes.
Esto inevitablemente causa confusión. Observemos entonces el proceso de ejecución:
    for _, no := range rm.getGraph(ctx) {
       no := no

       g.Go(func() (err error) {

          defer func() {
             err := no.Terminates(err)
             if err != nil {
                l.Error(err, "failed to terminate node when running graph")
             }
          }()

          err = no.Wait(ctx)
          if err != nil {
             return err
          }

          err = no.fn(ctx, no.resource)

          return err
       })
    }
Es extremadamente simple y directo. Para cada node, espera a que se ejecuten todos sus nodes de entrada (padres), luego ejecuta su propia runFunc, y propaga cualquier error potencial a todos los nodes posteriores en la cadena que esperan ejecución, abortándolos anticipadamente.
Aquí no entiendo muy bien por qué no usar una ordenación topológica para resolver este problema clásico bien definido.
Inicialización
La inicialización del GraphManager utiliza una variable global thread local. Después de la inicialización, se “lanza al aire” (en el ctx), una forma común de inyección de dependencias en varios frameworks de API.
    func (c *Controller) NewContext(req ctrl.Request) context.Context {
            ctx := context.TODO()
            application.SetName(&ctx, c.GetName())
            application.SetVersion(&ctx, c.GetVersion())
            application.SetGitCommit(&ctx, c.GetGitCommit())
            ctx = sgraph.WithGraph(ctx)

            logger.Set(&ctx, c.Log.WithValues("request", req))

            return ctx
    }

    func WithGraph(ctx context.Context) context.Context {
            return context.WithValue(ctx, &graphKey, graph.NewResourceManager())
    }

    func Get(ctx context.Context) graph.Manager {
            g := ctx.Value(&graphKey)
            if g == nil {
                    return nil
            }

            return g.(graph.Manager)
    }
Maximizando la Reutilización de Código: Controller
Excepto por el Controller HarborCluster que descartamos anteriormente, todos los Controllers de componentes en Harbor Operator combinan directamente este mismo Controller, extrayendo la lógica común de todos los Controllers, usando el mismo Run, el mismo Reconcile. ¿Cómo se logra?
- ¿Qué lógica se extrajo?
- ¿Cómo se manejan las diferencias?
- ¿Qué se sacrificó?
Estructura de Datos
La implementación de la interfaz por parte del Controller, aparte de implementar Reconciler, no tiene nada interesante. Primero veamos la definición de la estructura de datos del Controller:
    type ResourceManager interface {
            AddResources(context.Context, resources.Resource) error
            NewEmpty(context.Context) resources.Resource
    }

    type Controller struct {
            client.Client

            BaseController controllers.Controller
            Version        string
            GitCommit      string

            ConfigStore *configstore.Store
            rm          ResourceManager
            Log         logr.Logger
            Scheme      *runtime.Scheme
    }
Las cosas que no conocemos bien son solo BaseController y rm.
Al revisar, BaseController es básicamente un identificador, utilizado para identificar la información del propio Controller y alguna información de etiquetas. Entonces, las diferencias lógicas entre diferentes Controllers solo pueden existir dentro de ResourceManager. ResourceManager parece también una interfaz simple, y los que implementan ResourceManager son, efectivamente, los Controllers concretos; estudiaremos ejemplos específicos de ResourceManager al final.
    type Controller int

    const (
       Core                Controller = iota // core
       JobService                            // jobservice
       Portal                                // portal
       Registry                              // registry
       RegistryController                    // registryctl
       ChartMuseum                           // chartmuseum
       Exporter                              // exporter
       NotaryServer                          // notaryserver
       NotarySigner                          // notarysigner
       Trivy                                 // trivy
       Harbor                                // harbor
       HarborCluster                         // harborcluster
       HarborConfiguration                   // harborconfiguration
    )

    func (c Controller) GetFQDN() string {
       return fmt.Sprintf("%s.goharbor.io", strings.ToLower(c.String()))
    }

    func (c Controller) Label(suffix ...string) string {
       return c.LabelWithPrefix("", suffix...)
    }

    func (c Controller) LabelWithPrefix(prefix string, suffix ...string) string {
       var suffixString string
       if len(suffix) > 0 {
          suffixString = "/" + strings.Join(suffix, "-")
       }

       if prefix != "" {
          prefix = "." + prefix
       }

       return fmt.Sprintf("%s%s%s", prefix, c.GetFQDN(), suffixString)
    }
Lógica de Reconcile
Entonces, ¿cómo logra el Controller usar solo un Reconcile para reconciliar once CRDs de la familia Harbor junto con tantos recursos del sistema?
Según la información que ya conocemos, probablemente para cada CRD se utiliza un ResourceManager para definir los diversos recursos que este CRD necesita crear y reconciliar. Estos recursos definen sus dependencias a través del gráfico de dependencias, y para cada CRD se escribe una RunFunc concreta para realizar la reconciliación final.
    func (c *Controller) Reconcile(req ctrl.Request) (ctrl.Result, error) {
       ctx := c.NewContext(req)

       span, ctx := opentracing.StartSpanFromContext(ctx, "reconcile", opentracing.Tags{
          "resource.namespace": req.Namespace,
          "resource.name":      req.Name,
          "controller":         c.GetName(),
       })
       defer span.Finish()

       l := logger.Get(ctx)

       // Obtener la instancia

       object := c.rm.NewEmpty(ctx)

       ok, err := c.GetAndFilter(ctx, req.NamespacedName, object)
       if err != nil {
          // Error al leer el objeto
          return ctrl.Result{}, err
       }

       if !ok {
          // Objeto de solicitud no encontrado, podría haber sido eliminado después de la solicitud de reconciliación.
          // Los objetos propiedad se recolectan automáticamente como basura. Para lógica de limpieza adicional, usar finalizadores.
          l.Info("El objeto no existe")

          return ctrl.Result{}, nil
       }

       if !object.GetDeletionTimestamp().IsZero() {
          logger.Get(ctx).Info("El objeto se está eliminando")

          return ctrl.Result{}, nil
       }

       owner.Set(&ctx, object)

       if err := c.Run(ctx, object); err != nil {
          return c.HandleError(ctx, object, err)
       }

       return ctrl.Result{}, c.SetSuccessStatus(ctx, object)
    }
Lógica de Reconcile clásica. Parece que la magia está en c.Run:
    func (c *Controller) Run(ctx context.Context, owner resources.Resource) error {
       span, ctx := opentracing.StartSpanFromContext(ctx, "run")
       defer span.Finish()

       logger.Get(ctx).V(1).Info("Reconciliando objeto")

       if err := c.rm.AddResources(ctx, owner); err != nil {
          return errors.Wrap(err, "cannot add resources")
       }

       if err := c.PrepareStatus(ctx, owner); err != nil {
          return errors.Wrap(err, "cannot prepare owner status")
       }

       return sgraph.Get(ctx).Run(ctx)
    }
¡Ahí aparece rm! Después de agregar los recursos necesarios para un Controller concreto, PrepareStatus parece ser uno unificado. Combinando el código fuente de este método y la definición del CRD, descubrimos que asume que todos los componentes tienen el mismo Status. Otro diseño que sacrifica flexibilidad por simplicidad y consistencia. De hecho, este diseño sigue las normas promovidas por K8s, y se puede usar como referencia al diseñar CRDs. No lo detallaremos más aquí.
Última línea: sgraph.Get(ctx).Run(ctx). ¡Llega el gráfico de dependencias! Se toma del “aire” (ctx). Hasta aquí, esta parte de la lógica se cierra. La pregunta restante es: ¿cómo construyen los Controllers concretos que implementan ResourceManager el gráfico de dependencias y construyen su propia RunFunc?
Código como Configuración: ResourceManager
El último paso es casi natural.
Todos los Controllers que implementan ResourceManager deberían tener un estatus igual. Usaremos el ejemplo de harbor core para investigar.
Aparte de la parte utilizada para generar recursos específicos de K8s, debemos centrarnos en la parte que implementa la interfaz ResourceManager.
    func (r *Reconciler) NewEmpty(_ context.Context) resources.Resource {
       return &goharborv1.Core{}
    }

    func (r *Reconciler) AddResources(ctx context.Context, resource resources.Resource) error {
       core, ok := resource.(*goharborv1.Core)
       if !ok {
          return serrors.UnrecoverrableError(errors.Errorf("%+v", resource), serrors.OperatorReason, "unable to add resource")
       }

       service, err := r.GetService(ctx, core)
       if err != nil {
          return errors.Wrap(err, "cannot get service")
       }

       _, err = r.Controller.AddServiceToManage(ctx, service)
       if err != nil {
          return errors.Wrapf(err, "cannot add service %s", service.GetName())
       }

       configMap, err := r.GetConfigMap(ctx, core)
       if err != nil {
          return errors.Wrap(err, "cannot get configMap")
       }

       configMapResource, err := r.Controller.AddConfigMapToManage(ctx, configMap)
       if err != nil {
          return errors.Wrapf(err, "cannot add configMap %s", configMap.GetName())
       }

       secret, err := r.GetSecret(ctx, core)
       if err != nil {
          return errors.Wrap(err, "cannot get secret")
       }

       secretResource, err := r.Controller.AddSecretToManage(ctx, secret)
       if err != nil {
          return errors.Wrapf(err, "cannot add secret %s", secret.GetName())
       }

       deployment, err := r.GetDeployment(ctx, core)
       if err != nil {
          return errors.Wrap(err, "cannot get deployment")
       }

       _, err = r.Controller.AddDeploymentToManage(ctx, deployment, configMapResource, secretResource)
       if err != nil {
          return errors.Wrapf(err, "cannot add deployment %s", deployment.GetName())
       }

       err = r.AddNetworkPolicies(ctx, core)

       return errors.W