ソースコードリーディング:Harbor-Operator
始める前に
なぜHarbor-Operatorなのか
Worse is Better?
優れたソフトウェアとは何でしょうか?
80年代末の有名な記事「The Rise of Worse is Better」で、著者は優れたソフトウェア設計は単純さ、正確さ、一貫性、完全性という4つの特性を考慮すべきだと述べています。
記事では、the right thing と worse is better(この名称は否定的な意味ではないことを指摘しておきます)という2つのソフトウェア設計理念が紹介されています。どちらの理念も上記の4つの特性を中心に展開されていますが、これらの特性に対する優先順位が異なります。
The right thing
- 単純さ - 設計は単純で理解しやすいものでなければなりません。インターフェースの単純さは実装の単純さよりも重要です。
- 正確さ - 設計は正確でなければなりません。この点については一切の譲歩は許されません。
- 一貫性 - 一貫性は正確さと同じくらい重要です。そのため、単純さと完全性は多少犠牲にしても構いません。
- 完全性 - 設計は様々な可能性を考慮しなければなりません。単純さを保つために完全性を過度に犠牲にしてはいけません。
Worse is better
- 単純さ - 設計は単純で理解しやすいものでなければなりません。実装の単純さはインターフェースの単純さよりも重要です。単純さが最も重要な特性です。
- 正確さ - 設計は正確でなければなりません。もちろん、単純さを保つことは正確さよりも少し重要です。
- 一貫性 - 設計はあまりにも一貫性を欠いてはいけません。単純さを保つために一貫性を犠牲にすることができます。単純さを保証する限り、完全性のために一貫性を犠牲にすることもできます。
- 完全性 - 設計は様々な可能性を考慮しなければなりません。設計を単純にするために、いつでも完全性を犠牲にすることができます。
その後、著者は両者の多くの例を挙げ、なぜ worse-is-better が当時のソフトウェア業界を席巻しているのかを論証しています。
この2つの理念に優劣はありません。今日でも私たちの身の回りに存在し、実際の状況はしばしば両者の間を行き来します。私たちは優れた、美的価値のある設計を望みますが、コストや人的要因も考慮しなければなりません。最終的には、現実世界の問題を解決するために、品質が基準を満たし、動作するソフトウェアを提供する必要があります。そして、ソフトウェアの作成・保守コストは、問題自体の価値を絶対に上回ってはなりません。
Golang - 言語として
Golangは、ほぼ間違いなく worse is better 理念の典型例と言えるでしょう:
- Googleが長年にわたってC++で積み重ねてきた実践的な経験が凝縮されています。
- 非常に単純で、複雑な機能は一切ありません。そのため、問題を解決するための基本的な構成要素はほぼ1種類しかありません。これはつまり:
- 言語自体についてほとんど学ぶ必要なく、容易に習得できる。
- コードが非常に読みやすい。
- コンパイルが高速で、コンパイル速度のためにジェネリクスさえも犠牲にしました。
- goroutineを使って並行タスクを非常に簡単に実行できます。
- 例外スタックという言語機能をほぼ捨て、エラーチェックと処理を強制します。
- 一度コンパイルすれば、どこでも実行できます。
Kubernetes - プラットフォームとして
Kubernetesは皆さんよくご存知なので、釈迦に説法はしません。一言で言えば:概念的に非常にシンプルなAPI設計を提供し、サイバネティクスに基づく調和(Reconcile)メカニズムを補完することで、コンテナ化されたソフトウェアを自動的にデプロイ、拡張、運用できるようにします。
k8sは、このAPI仕様と調和メカニズムを公開することで、開発者がその機能を拡張できるようにしています。これにより、開発者はOperatorパターンを実装できます:ソフトウェアの設定、デプロイ(Day-1)および運用、バックアップ、フェイルオーバー(Day-2)に関する知識を、ソフトウェアを操作するためのソフトウェアとして記述し、これらの複雑でエラーが発生しやすい操作を自動化することで、信頼性を高め、コストを削減します。
では、Harbor Operatorを選んだ理由は、その優れた設計にあります。優れたプラットフォーム上で、シンプルな言語特性を用い、過度な技巧に頼ることなく、SOLID設計原則に沿ったいくつかの重要な設計を通じて、実用的で美的価値のあるソフトウェアシステムを実現しており、the right thing 理念の実践者と見なすことができるからです。
著者のコードにはほとんどコメントがありませんが、異常に読みやすいです。これは、システム全体の設計のおかげでもあります。
目標
問題を抽象化・単純化することは、必然的に柔軟性の犠牲を伴います。一方、Harbor Operatorは、最大限の思考負荷軽減をもたらすために柔軟性を完全に捨てており、Operatorの開発はソフトウェアの設定を宣言するようなものになっています。
client-goを使って手動でoperatorを書くことは、golangにジェネリクスが欠けていることもあり、まさに自虐行為です。プロジェクト全体に大量のボイラープレートコードが溢れかえることになります。client-goで手動で書くにしても、本当にゼロから書き始める人はいないと信じています。
そこでkubebuilderが登場しました。Kubernetes Clientの作成、Kubernetes API Serverへのリクエストの監視、リクエストのキューイングなどの操作を、共通ライブラリであるcontroller runtimeと共通ツールであるcontroller toolsに抽象化し、開発者がAPIオブジェクト変更リクエストのビジネスロジック開発に集中できるように、スキャフォールディングコードを生成します。
Kubebuilderは依然としてビジネスロジックの多様性に一筋の光明を残していますが、Harbor Operatorはその上でさらに極限を追求し、概念の一貫性と単純さを求めて柔軟性を完全に犠牲にしています。そして、それが直面しているビジネスは、まさにこのアプローチに非常に適しています。
したがって、今回のソースコードリーディングにおける主な目標は、Harbor Operatorから以下を学ぶことです:
- Day-1操作をどのように行うか
- 同じControllerコードを使用して、11の異なるレベルのCRDのControllerを実現するために、operatorコードの冗長性をさらにどのように削減するか
- DAGを利用してリソース間の依存関係を解決する方法(著者はこれについて特許を出願しているようです)
また、以下については重点的に研究しません:
- Harbor OperatorにおけるDay-2操作(実際、現在のバージョンではこの部分の機能はまだ不安定です)
- Harbor自体のソースコードと機能
ソースコードリーディング
静的構造
ディレクトリ構造
ここではディレクトリのみをリストアップします。
    root
    ├── apis
    │   ├── goharbor.io
    │   │   └── v1alpha3
    │   └── meta
    │       └── v1alpha1
    ├── controllers
    │   ├── controller_string.go
    │   ├── controllers.go
    │   └── goharbor
    │       ├── chartmuseum
    │       ├── controller_test.go
    │       ├── core
    │       ├── exporter
    │       ├── harbor
    │       ├── harborcluster
    │       ├── internal
    │       ├── jobservice
    │       ├── notaryserver
    │       ├── notarysigner
    │       ├── portal
    │       ├── registry
    │       ├── registryctl
    │       └── trivy
    ├── pkg
    │   ├── builder
    │   ├── cluster
    │   │   ├── controllers
    │   │   │   ├── cache
    │   │   │   ├── common
    │   │   │   ├── database
    │   │   │   │   └── api
    │   │   │   ├── harbor
    │   │   │   └── storage
    │   │   ├── gos
    │   │   ├── k8s
    │   │   └── lcm
    │   ├── config
    │   │   ├── harbor
    │   │   └── template
    │   ├── controller
    │   │   ├── errors
    │   │   ├── internal
    │   │   │   └── graph
    │   │   └── mutation
    │   ├── event-filter
    │   ├── exit
    │   ├── factories
    │   │   ├── application
    │   │   ├── logger
    │   │   └── owner
    │   ├── graph
    │   ├── harbor
    │   ├── image
    │   ├── manager
    │   ├── resources
    │   │   ├── checksum
    │   │   └── statuscheck
    │   ├── scheme
    │   ├── setup
    │   ├── status
    │   ├── template
    │   ├── tracing
    │   ├── utils
    │   │   └── strings
    │   └── version
    ...
主要インターフェース

システムアーキテクチャ
v1.0.1時点で、Harbor Operatorは現在主にHarborシステムのDay-1操作を担当しています。 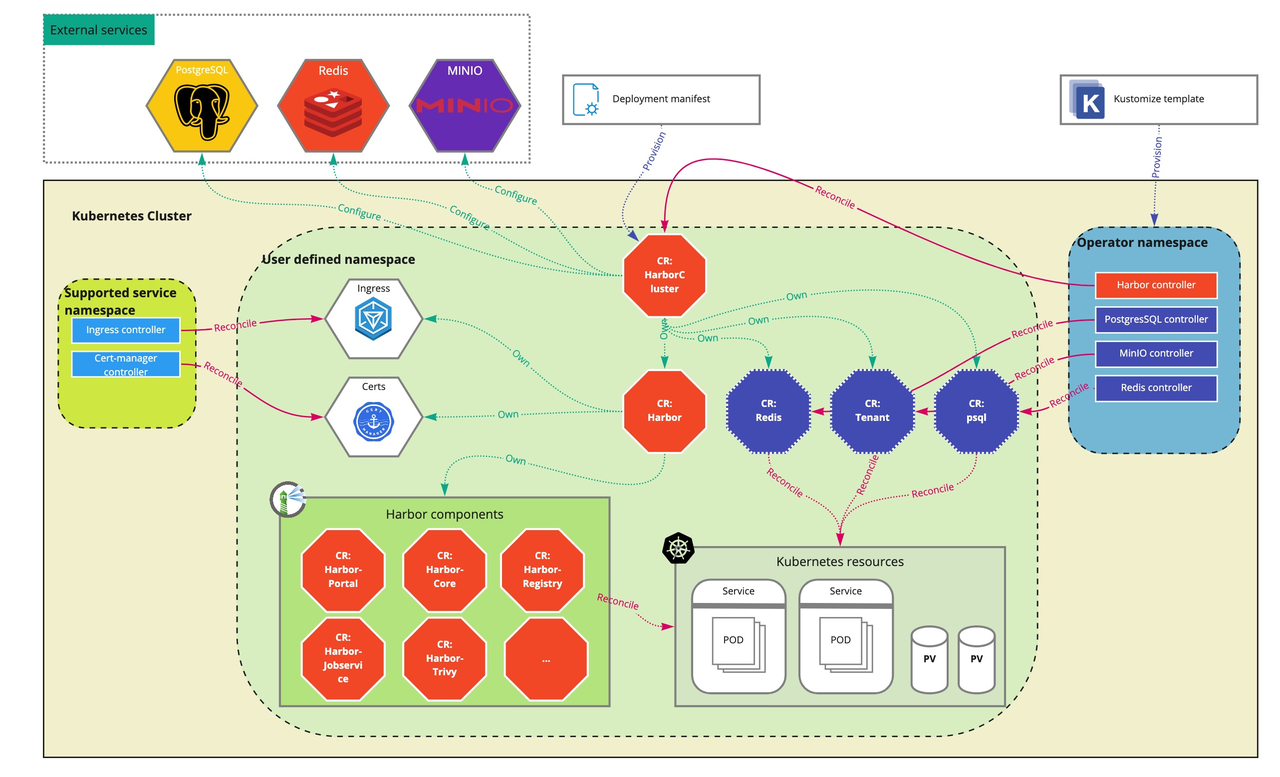
大局を捉える:HarborCluster
まず、それほど重要ではない部分を除外しましょう:HarborCluster というCRDとそのControllerの実装です。
なぜ特別なのでしょうか?まず、システムアーキテクチャ内での位置を観察してください:最上位に位置し、Harborシステム自体とそれが依存するすべてのステートフルサービスを管理しています。これは、プロジェクトの歴史と、システムアーキテクチャ内での特殊な地位の両方から説明する必要があります。
システムアーキテクチャの観点から見ると、このHarborCluster CRDは定義上、Harbor CRDと非常に似通っており、コードに大量の冗長性があり、あまり美しく見えません。これは、システム全体の中で最も上(外)の層にあるCRDとして、ユーザーに直接向き合っているためです。ユーザーにHarborのデプロイに必要なすべての設定項目を宣言的に提供できなければなりません。さらに、Harbor自体がステートレスなサービスであるため、完全なデプロイには、HarborCluster CRDがHarborシステムが依存するすべてのステートフルサービス(Postgres、Minio、Redisなど)を管理する必要があります。
一方、Harborシステム自体に必要な情報はすでにHarbor CRDで定義されています。したがって、HarborCluster CRDの冗長な部分は、この情報をHarbor CRDに完全かつ正確に渡すことです。さらに、HarborCluster CRDは、自身の責務の境界外にあるステートフルサービスのCRDも管理する必要があるため、HarborおよびHarborのすべてのサブコンポーネントのControllerロジックを完全に使用することはできません。
歴史的な観点から見ると、Harbor OperatorはもともとOVH Cloudのプライベートプロジェクトであり、後にgoharborコミュニティに寄贈されました。したがって、gitの履歴を観察すると、HarborClusterのCRD定義とそのControllerの実装が、システム内の他のControllerとこれほど大きな不一致を持つ理由は、それがコミュニティによって寄贈された後発者であり、Harbor Operatorの設計当初にその果たすべき機能が考慮されていなかったからです。
HarborCluster Controller自体の実装は、私たちが普段目にする、Controller-runtimeを使用して実装された大多数のControllerと大きな違いはないため、詳細な研究は行いません。
HarborCluster Controller

Harbor Core Controller

リソース間の依存関係を解決する:Dependency Graph
依存グラフは、プロジェクト全体の中で比較的独立したモジュールですが、実際にはHarbor Operatorのすべてのcontrollerの実行エンジンとしての役割を担っています。本質的には、Kubernetes内のさまざまなリソース間に相互依存関係があり、一部のリソースのデプロイと調和は他のリソースのデプロイと調和に依存しているという観察に基づいています。例えば、DeploymentはConfigmapに依存する可能性があります。最終的に、これらの依存関係は依存グラフを形成します。実際、このグラフはDAGであるべきです。ここで必要なインターフェース定義は以下の通りです:
    package graph

    type Resource interface{}

    type RunFunc func(context.Context, Resource) error

    type Manager interface {
            Run(ctx context.Context) error
            AddResource(ctx context.Context, resource Resource, blockers []Resource, run RunFunc) error
    }

    type resourceManager struct {
       resources map[Resource][]Resource
       functions map[Resource]RunFunc

       lock sync.Mutex
    }
- ここで、
Resourceは抽象的なリソースを定義しています。このモジュールはリソースが何を表すかに関心がなく、言語の表現力の制限の中で最大限の柔軟性を保つために、トップタイプであるinterface{}を使用しています。 RunFuncは、特定のResourceに対してどのように操作を行うかを担当します。ここでRunFuncは型安全性の問題に直面します:interface{}はコンパイラがその型について何も知らないことを意味し、手がかりがありません。しかし、RunFuncはこの「何でもあり得る」型を使って何かをしなければなりません。したがって、型アサーション(強制変換)を行う必要があると考えられます。各リソースのRunFuncが手動で具体的な型にキャストしなければならないとしたら、非常に退屈でうんざりするものになります。後で、Harbor Operatorがどのようにこの面倒な作業を一箇所に集中させるかを見てみましょう。Managerには2つのメソッドしかありません:リソースの追加とグラフの実行です。それぞれ研究する必要があります。Managerを実装したresourceManagerのデータ構造定義も非常にシンプルです:resource -> blockersのマップresource -> runFuncのマップ- マップ操作の並行性を処理するためのロック。ここから、著者が型安全性を失う代わりに並行安全性を保証する
Sync Mapのようなデータ構造を好まないことがわかります。これにより、著者がどのようにして多くの(11のコンポーネントの)RunFuncを処理するのか、さらに興味が湧きます。
グラフである以上、グラフのデータ構造とこのグラフを構築するファクトリメソッドが必要です。resourceManagerのデータ構造は少し生硬に見え、これが本当のグラフなのかどうかは定かではありません。
AddResource
シグネチャから、AddResourceは追加されるリソース自体とそのすべての依存関係、および対応するrunFuncを追加することがわかります。注目すべき点は、まず何にも依存しないリソース(つまり、出次数が0のリソース)を追加しなければならないことです。
    func (rm *resourceManager) AddResource(ctx context.Context, resource Resource, blockers []Resource, run RunFunc) error {
       if resource == nil {
          return nil
       }

       if run == nil {
          return errors.Errorf("unsupported RunFunc value %v", run)
       }

       span, _ := opentracing.StartSpanFromContext(ctx, "addResource", opentracing.Tags{
          "Resource": resource,
       })
       defer span.Finish()

       nonNilBlockers := []Resource{}

       for _, blocker := range blockers {
          if blocker == nil {
             continue
          }

          nonNilBlockers = append(nonNilBlockers, blocker)

          _, ok := rm.resources[blocker]
          if !ok {
             return errors.Errorf("unknown blocker %+v", blocker)
          }
       }

       rm.lock.Lock()
       defer rm.lock.Unlock()

       _, ok := rm.resources[resource]
       if ok {
          return errors.Errorf("resource %+v already added", resource)
       }

       rm.resources[resource] = nonNilBlockers
       rm.functions[resource] = run

       return nil
    }
Run
このパッケージのほぼすべての重要なロジックはRunメソッドにあります。まず前半部分を見てみましょう:
    func (rm *resourceManager) Run(ctx context.Context) error {
       span, ctx := opentracing.StartSpanFromContext(ctx, "walkGraph", opentracing.Tags{
          "Nodes.count": len(rm.resources),
       })
       defer span.Finish()

       g := errgroup.Group{}
       l := logger.Get(ctx)

       for _, no := range rm.getGraph(ctx) {
       ...
出ました!getGraph。どうやらグラフを構築するようです。中に入ると、やはりresourceManagerは単なるビルダーであり、本当のグラフはここに隠れていて、隣接リストで表現されています。一見すると複雑に見えます:
    type node struct {
       resource Resource
       fn       RunFunc

       parent      chan error
       parentLock  *sync.Mutex
       parentCount int

       children     []chan<- error
       childrenLock []*sync.Mutex
    }

    func (no *node) Wait(ctx context.Context) error {...}
    func (no *node) Terminates(err error) (result error) {...}
    func (no *node) AddChild(child *node) {...}
なぜParentとchildrenがチャネルなのか、なぜそんなに多くのロックが必要なのか。グラフの構築過程を観察してみましょう:
    func (rm *resourceManager) getGraph(ctx context.Context) []*node {
       span, _ := opentracing.StartSpanFromContext(ctx, "getGraph")
       defer span.Finish()

       rm.lock.Lock()
       defer rm.lock.Unlock()

       graph := make(map[Resource]*node, len(rm.resources))
       result := make([]*node, len(rm.resources))

       i := 0

       for resource, blockers := range rm.resources {
          blockerCount := len(blockers)

          node := &node{
             resource: resource,
             fn:       rm.functions[resource],

             parent:      make(chan error, blockerCount),
             parentLock:  &sync.Mutex{},
             parentCount: blockerCount,

             children:     []chan<- error{},
             childrenLock: []*sync.Mutex{},
          }
          graph[resource] = node
          result[i] = node

          i++

          blockers := blockers

          defer func() {
             for _, blocker := range blockers {
                graph[blocker].AddChild(node)
             }
          }()
       }

       return result
    }
なるほど、依存関係が逆転しています。今度は、依存される側が依存する側を指しています。各リソースに対してnodeを構築し、同時にリソースの各依存関係に対して、このリソースのparentチャネルを依存関係のchildrenに追加します。最終的なグラフはnodeの集合です。
これではどうしても混乱してしまいます。では、実行過程を観察してみましょう:
    for _, no := range rm.getGraph(ctx) {
       no := no

       g.Go(func() (err error) {

          defer func() {
             err := no.Terminates(err)
             if err != nil {
                l.Error(err, "failed to terminate node when running graph")
             }
          }()

          err = no.Wait(ctx)
          if err != nil {
             return err
          }

          err = no.fn(ctx, no.resource)

          return err
       })
    }
非常に単純で強引です。各nodeについて、その入次数nodeの実行が完了するのを待ってから、自身のrunFuncを実行し、潜在的なエラーをその後のチェーンで待機しているすべてのnodeに伝播させ、早期に中止させます。
ここで、なぜトポロジカルソートを使ってこの定義が明確な古典的な問題を解決しないのか、非常に理解できません。
初期化
    GraphManagerの初期化には、スレッドローカルなグローバル変数が使用され、初期化後は空中(ctx)に投げられます。これは、さまざまなAPIフレームワークでよく見られる依存性注入の方法です。
    func (c *Controller) NewContext(req ctrl.Request) context.Context {
            ctx := context.TODO()
            application.SetName(&ctx, c.GetName())
            application.SetVersion(&ctx, c.GetVersion())
            application.SetGitCommit(&ctx, c.GetGitCommit())
            ctx = sgraph.WithGraph(ctx)

            logger.Set(&ctx, c.Log.WithValues("request", req))

            return ctx
    }

    func WithGraph(ctx context.Context) context.Context {
            return context.WithValue(ctx, &graphKey, graph.NewResourceManager())
    }

    func Get(ctx context.Context) graph.Manager {
            g := ctx.Value(&graphKey)
            if g == nil {
                    return nil
            }

            return g.(graph.Manager)
    }
コードの再利用性を極限まで高める:Controller
以前に除外したHarborCluster Controllerを除いて、Harbor OperatorのすべてのコンポーネントのControllerは、この同じControllerを直接組み合わせており、すべてのControllerの共通ロジックを抽出し、同じRun、同じReconcileを使用しています。どうやって実現しているのでしょうか?
- どのようなロジックが抽出されたか
- 相違点をどのように処理するか
- 何が犠牲になったか
データ構造
Controllerのインターフェース実装は、Reconcilerを実装している以外は特に面白い点はありません。では、まずControllerのデータ構造定義を見てみましょう:
    type ResourceManager interface {
            AddResources(context.Context, resources.Resource) error
            NewEmpty(context.Context) resources.Resource
    }

    type Controller struct {
            client.Client

            BaseController controllers.Controller
            Version        string
            GitCommit      string

            ConfigStore *configstore.Store
            rm          ResourceManager
            Log         logr.Logger
            Scheme      *runtime.Scheme
    }
よくわからないものはBaseControllerとrmだけです。
BaseControllerを追ってみると、基本的にはController自身の情報やラベル情報を識別するための識別子です。すると、異なるController間の異なるロジックの差異点は、ResourceManagerの中にしか存在しない可能性があります。ResourceManagerも非常にシンプルなインターフェースに見え、ResourceManagerを実装しているのはやはり各具体的なControllerです。最後にResourceManagerの具体例を研究します。
    type Controller int

    const (
       Core                Controller = iota // core
       JobService                            // jobservice
       Portal                                // portal
       Registry                              // registry
       RegistryController                    // registryctl
       ChartMuseum                           // chartmuseum
       Exporter                              // exporter
       NotaryServer                          // notaryserver
       NotarySigner                          // notarysigner
       Trivy                                 // trivy
       Harbor                                // harbor
       HarborCluster                         // harborcluster
       HarborConfiguration                   // harborconfiguration
    )

    func (c Controller) GetFQDN() string {
       return fmt.Sprintf("%s.goharbor.io", strings.ToLower(c.String()))
    }

    func (c Controller) Label(suffix ...string) string {
       return c.LabelWithPrefix("", suffix...)
    }

    func (c Controller) LabelWithPrefix(prefix string, suffix ...string) string {
       var suffixString string
       if len(suffix) > 0 {
          suffixString = "/" + strings.Join(suffix, "-")
       }

       if prefix != "" {
          prefix = "." + prefix
       }

       return fmt.Sprintf("%s%s%s", prefix, c.GetFQDN(), suffixString)
    }
Reconcile ロジック
では、Controllerはどのようにして1つのReconcileだけで、harborファミリーの11のCRDとそれに伴う多くのシステムリソースをreconcileできるのでしょうか?
上記ですでに知っている情報によると、各CRDに対してResourceManagerを使用して、このCRDが作成および調和する必要のあるさまざまなリソースを定義し、これらのリソースは依存グラフを通じて依存関係を定義し、各CRDに対して具体的なRunFuncを記述して最終的な調和を完了するはずです。
    func (c *Controller) Reconcile(req ctrl.Request) (ctrl.Result, error) {
       ctx := c.NewContext(req)

       span, ctx := opentracing.StartSpanFromContext(ctx, "reconcile", opentracing.Tags{
          "resource.namespace": req.Namespace,
          "resource.name":      req.Name,
          "controller":         c.GetName(),
       })
       defer span.Finish()

       l := logger.Get(ctx)

       // インスタンスを取得

       object := c.rm.NewEmpty(ctx)

       ok, err := c.GetAndFilter(ctx, req.NamespacedName, object)
       if err != nil {
          // オブジェクトの読み取りエラー
          return ctrl.Result{}, err
       }

       if !ok {
          // リクエストオブジェクトが見つかりません。reconcileリクエストの後に削除された可能性があります。
          // 所有されているオブジェクトは自動的にガベージコレクションされます。追加のクリーンアップロジックにはファイナライザーを使用してください。
          l.Info("Object does not exists")

          return ctrl.Result{}, nil
       }

       if !object.GetDeletionTimestamp().IsZero() {
          logger.Get(ctx).Info("Object is being deleted")

          return ctrl.Result{}, nil
       }

       owner.Set(&ctx, object)

       if err := c.Run(ctx, object); err != nil {
          return c.HandleError(ctx, object, err)
       }

       return ctrl.Result{}, c.SetSuccessStatus(ctx, object)
    }
非常に典型的なReconcileロジックです。どうやら工夫はc.Runの中にあるようです:
    func (c *Controller) Run(ctx context.Context, owner resources.Resource) error {
       span, ctx := opentracing.StartSpanFromContext(ctx, "run")
       defer span.Finish()

       logger.Get(ctx).V(1).Info("Reconciling object")

       if err := c.rm.AddResources(ctx, owner); err != nil {
          return errors.Wrap(err, "cannot add resources")
       }

       if err := c.PrepareStatus(ctx, owner); err != nil {
          return errors.Wrap(err, "cannot prepare owner status")
       }

       return sgraph.Get(ctx).Run(ctx)
    }
やはりrmがここに登場しました。特定のControllerが必要とするリソースを追加した後、PrepareStatusは統一されたもののようです。このメソッドのソースコードとCRD定義を組み合わせると、すべてのコンポーネントが同じStatusを持つことを前提としていることがわかります。これもまた、柔軟性を犠牲にして単純さと一貫性を求めた設計です。実際、この設計はK8sが推奨する規範に従っており、CRDを設計する際の参考にすることができます。ここでは詳しく説明しません。
最後の行:sgraph.Get(ctx).Run(ctx)。依存グラフが来ました。空中(ctx)から取り出します。これでこの部分のロジックは閉じました。残っている問題は:ResourceManagerを実装した各具象Controllerが、どのように依存グラフを構築し、自身のRunFuncを構築するかです。
コードが設定となる:ResourceManager
最後のステップは、水が流れるように自然に進みます。
ResourceManagerを実装したすべてのControllerは、地位的に平等であるはずです。harbor coreの一例を借りて探ってみましょう。
具体的なK8sリソースを生成する部分を除いて、注目すべきはResourceManagerインターフェースを実装した部分です。
    func (r *Reconciler) NewEmpty(_ context.Context) resources.Resource {
       return &goharborv1.Core{}
    }

    func (r *Reconciler) AddResources(ctx context.Context, resource resources.Resource) error {
       core, ok := resource.(*goharborv1.Core)
       if !ok {
          return serrors.UnrecoverrableError(errors.Errorf("%+v", resource), serrors.OperatorReason,